La reconnaissance optique de caractères (OCR) peut sembler complexe et étrangère à la plupart d'entre nous, mais nous utilisons de plus en plus fréquemment cette technologie avancée. Son utilisation est très répandue, allant de la traduction de textes étrangers dans la langue de notre choix à la numérisation de documents papier. L' OCR a encore progressé et est devenue une composante essentielle de notre écosystème numérique.
Cependant, il y a beaucoup trop peu d'informations sur cette technologie innovante, et il est temps de la mettre en lumière.
Qu'est-ce que la reconnaissance optique de caractères (OCR) ?

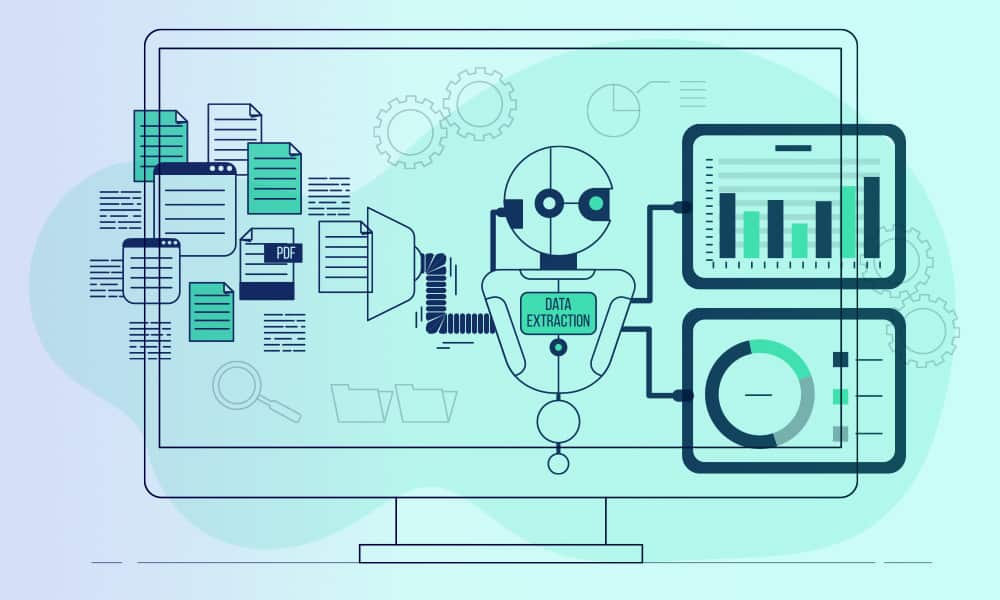
Appartenant à la famille de l'intelligence artificielle, la reconnaissance optique de caractères (OCR) est la conversion électronique de textes provenant de notes manuscrites, de textes imprimés extraits de vidéos, d'images et de documents numérisés en un format numérique lisible par machine.
Il est possible d'encoder du texte à partir d'un document imprimé et de le modifier, de le stocker ou de le modifier électroniquement pour le stocker, le récupérer et l'utiliser pour créer des modèles ML à l'aide de la technologie OCR.
Il existe deux types de base d'OCR - le traditionnel et l'écrit à la main. Bien que les deux travaillent vers le même résultat, ils diffèrent dans la façon dont ils extraient les informations.
En reconnaissance optique de caractères (OCR) traditionnelle, le texte est extrait en fonction des styles de police disponibles avec lesquels les systèmes OCR ont été entraînés. En revanche, en OCR manuscrite, où chaque style d'écriture est unique, la lecture et l'encodage représentent un défi. Contrairement au texte dactylographié, qui est uniforme, le texte manuscrit est propre à chaque individu. L'OCR manuscrite nécessite donc un entraînement plus poussé pour une reconnaissance précise des formes.
Pourquoi l'OCR est-il important ?
Alors que la transformation numérique prend une place prépondérante dans le monde, nous assistons à la fin des systèmes et processus obsolètes et obsolètes. Bien que cette transition soit incroyable, elle s’accompagne de son propre ensemble de défis préliminaires. Il peut s'agir de flux de travail commerciaux impliquant la sauvegarde de supports d'impression comme moyen de procédure de saisie de données.
Lorsque les ressources imprimées sont numérisées, elles se présentent souvent sous un format d'image, dans lequel le texte ne peut pas être modifié, manipulé ou intégré dans des modèles d'IA à des fins de formation et de traitement. Pour les transformer en actifs numériques prêts à l’emploi, ils doivent être identifiés et traités.
La technologie OCR s'en charge en numérisant et en convertissant le texte des images, des vidéos et d'autres formats en données pouvant être alimentées sur des plates-formes, des langages de programmation et des bases de données.
Cet aspect particulièrement inévitable de la transformation numérique alimente la croissance du marché de l'OCR, où il est estimé à un TCAC de 14.32 % pour être évalué à 40 milliards de dollars d'ici 2032. Par ailleurs, avec l'essor de la vision par ordinateur et sa myriade de cas d'utilisation , la technologie OCR est devenue le pivot autour duquel des innovations et des solutions peuvent être développées.
Cela pourrait aller de la numérisation des prescriptions des médecins dans le domaine de la santé à la lecture des panneaux dans les voitures autonomes, l'OCR étant la technologie sous-jacente à l'origine du changement.
Comment fonctionne la technologie OCR

La traduction électronique de textes hors ligne en bits numériques est une tâche très intéressante et minutieuse. Pour vous donner une brève idée de la façon dont cela fonctionne, voici une description complète :
Balayage
La première étape du processus implique l'utilisation de scanners optiques pour numériser les documents et isoler les caractères et les données de tout le reste. Le fichier numérisé est stocké sous forme d'image.
Raffinage
Étant donné que tous les documents et feuilles n'ont pas la même qualité, toutes les images sont affinées pour une optimisation de la qualité. Cela implique d'aligner le texte, de lisser les pixels, de rendre le texte plus clair, etc. Ce processus rend le texte lisible.
Classement
Une fois l'image affinée, le texte est classé et séparé en groupes. Cela implique l'utilisation de techniques de segmentation d'images pour classer le texte en catégories.
Reconnaissance des personnages
Une fois le texte classé, les modèles et algorithmes OCR tels que la reconnaissance de formes et de caractéristiques entrent en action pour identifier le texte et les lettres. Alors que la reconnaissance de formes recherche l'écriture manuscrite, les polices, les formats de texte et d'autres aspects, la reconnaissance de fonctionnalités identifie des modèles tels que les courbes, la direction des lignes, les lignes, etc.
Post-traitement
Une fois les textes identifiés, un résultat est généré, généralement sous forme de fichier numérique. Il est essentiel de noter que les résultats ne sont pas précis à 100 %, car la qualité du résultat dépend de la qualité du papier, de l'écriture manuscrite, des motifs de texte étranges, des algorithmes, etc.
[À lire également : La reconnaissance optique de caractères dans le secteur de la santé : cas d’utilisation, avantages et inconvénients ]

Types d'OCR
L'OCR n'implique pas seulement la numérisation de texte sur papier mais aussi de texte dans tout autre format autre que les documents. Puisque ses types et ses applications sont divers, les techniques et approches déployées sont également distinctes.
Reconnaissance intelligente des motsCela capture l'écriture manuscrite et le texte cursif, ce qui la rend idéale pour numériser n'importe quel journal ou document manuscrit.
| Type de ROC | Ce que cela implique |
| Reconnaissance intelligente des caractères | Ceci est très similaire à la reconnaissance de mots, mais au lieu de scanner l'intégralité du texte, il recherche des caractères spécifiques. |
| Reconnaissance optique de caractères | Celui-ci détecte le texte tapé mais, comme son nom l'indique, il n'identifie qu'un seul caractère à la fois. |
| Reconnaissance optique de mots | Semblable à la reconnaissance de caractères, cette fonctionnalité identifie les mots et le texte au lieu de simplement les caractères dans les images avec des textes saisis. |
| Reconnaissance optique des marques | Les données marquées par l'homme telles que les réponses OMR, les marques sur les bulletins de vote, les coches sur les feuilles de réponses et bien plus encore sont identifiées grâce à cette technique. |
Avantages de la ROC

La reconnaissance optique de caractères (OCR ) offre de nombreux avantages, dont voici quelques exemples :
Augmentez la vitesse du processus :
En convertissant rapidement les données non structurées en informations lisibles par machine et consultables, la technologie contribue à augmenter la vitesse des processus métier.
Augmente la précision :
Le risque d'erreurs humaines est éliminé, ce qui améliore la précision globale de la reconnaissance des caractères.
Réduit les coûts de traitement :
Le logiciel de reconnaissance optique de caractères n'est pas entièrement dépendant d'autres technologies, ce qui réduit les coûts de traitement.
Améliore la productivité :
Étant donné que les informations sont facilement disponibles et consultables, les employés disposent de plus de temps pour effectuer des tâches productives et atteindre leurs objectifs.
Améliore la satisfaction client :
La disponibilité des informations dans un format facilement consultable garantit des niveaux de satisfaction plus élevés et une meilleure expérience client.
Cas d'utilisation et applications
Conservation des documents / Numérisation des documents

Banque et finances
Le secteur bancaire et financier utilise la technologie OCT à fond. Cette technologie contribue à améliorer la prévention des fraudes à la sécurité, à réduire les risques et à accélérer le traitement. Les banques et les applications bancaires utilisent l'OCR pour extraire des données cruciales des chèques, telles que le numéro de compte, le montant et la signature manuscrite. OCR aide à accélérer le traitement des demandes de prêt et d'hypothèque, des factures et des fiches de paie.
Avant que l'OCR ne devienne plus courant, tous les documents bancaires tels que les dossiers, les reçus, les relevés et les chèques étaient physiques. Grâce à la numérisation OCR, les banques et les institutions financières peuvent rationaliser les processus, éliminer les erreurs manuelles et améliorer l'efficacité des processus en accédant rapidement aux données.
Reconnaissance de plaque d'immatriculation
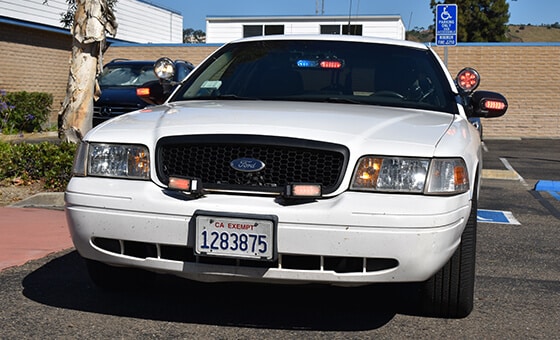
La technologie OCR aide à mettre en œuvre des règles de sécurité routière pour éviter la fraude et les crimes. Étant donné que les plaques d'immatriculation d'un véhicule sont liées aux informations d'identification du conducteur, l'identification est plus facile.
De plus, les plaques d'immatriculation consistent en un ensemble bien écrit de chiffres et de texte qui n'est pas difficile à lire pour le modèle d'IA, ce qui le rend plus facile et plus précis.
Text-to-speech
L'application de synthèse vocale de la technologie OCR est une excellente aide pour que les personnes malvoyantes fonctionnent avec une plus grande facilité. La technologie OCR aide à numériser des textes physiques et numériques et à utiliser des appareils vocaux. Le contenu est ensuite lu à haute voix. Bien que l'aspect synthèse vocale de la technologie OCR ait été l'une des premières applications, il a maintenant évolué et avancé pour répondre aux besoins uniques des personnes malvoyantes en prenant en charge plusieurs dialectes et langues.
Transcription de Multi-catégorie Documents papier numérisés Jeux de données
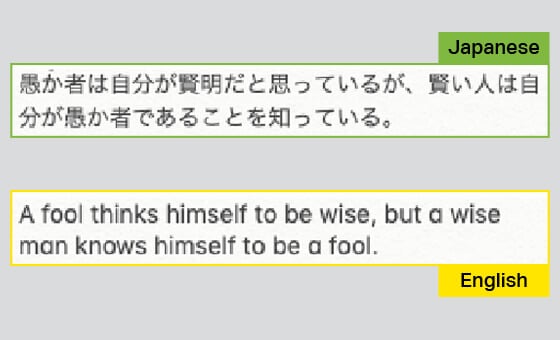
Transcrire des étiquettes médicales avec OCR
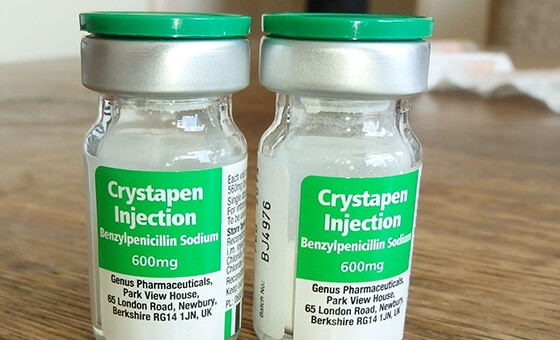
Grâce à l'OCR, le secteur de la santé peut numériser, stocker et rechercher rapidement les antécédents médicaux d'un patient. L'OCR permet de numériser et de stocker les rapports d'analyse, l'historique des traitements, les dossiers hospitaliers, les dossiers d'assurance, les radiographies et d'autres documents. En numérisant, transcrivant et stockant les étiquettes médicales, l'OCR facilite la rationalisation du flux de processus et accélère les soins de santé.
Détecter les informations sur les rues/routes et extraire les données des panneaux de rue avec OCR
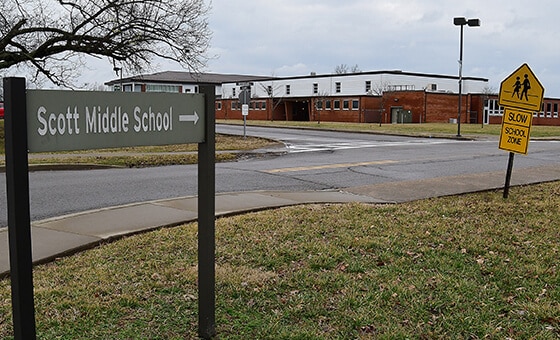
Développer un reconnaissance intelligente des caractères outil, vous devez l'entraîner avec l'ensemble de données spécifique au projet.
Chez Shaip, nous fournissons un ensemble de données documentaires entièrement personnalisé pour développer une reconnaissance optique de caractères (OCR) hautement performante pour les modèles d'IA et d'apprentissage automatique. Notre processus OCR spécialisé contribue à l'élaboration de solutions optimisées pour nos clients.
[À lire également : Infographie sur la reconnaissance optique de caractères (OCR) – Définition, avantages, défis et cas d’utilisation ]
Nous proposons des ensembles de données complets et fiables contenant des milliers de données extraites de documents numérisés. Contactez nos experts en solutions OCR pour découvrir comment nous fournissons des ensembles de données évolutifs, abordables et personnalisés.