Services de collecte de données d'images pour la vision par ordinateur
Des ensembles de données d'images personnalisés et entièrement consentis — n'importe quel sujet, n'importe quel scénario, construits selon les spécifications de votre modèle.
Pourquoi l'ensemble de données de formation d'images est-il nécessaire pour la vision par ordinateur ?
La collecte de données d'images consiste à capturer, à rechercher et à organiser des ensembles de données d'images pour entraîner des modèles de vision par ordinateur et d'apprentissage automatique. Shaip collecte des images personnalisées et dûment consenties (visages, documents, objets, scènes et imagerie médicale) adaptées au domaine, à la résolution et aux exigences démographiques de chaque modèle, puis contrôle la qualité de chaque image selon la méthodologie Six Sigma.
Les modèles et les configurations de ML intelligents chargés d'identifier les objets et les modèles dans le cadre de leur fonctionnement doivent être formés de manière approfondie. Du suivi des interactions aux émotions humaines, les systèmes intelligents doivent avoir la base pour identifier les entités en premier lieu. La puissance de l'identification est fournie par des solutions de collecte de données d'images personnalisées.
La collecte de données d'images pour les systèmes de vision par ordinateur présente les avantages suivants :
- Référentiel unique spécifique à l'image
- Possibilité d'étiqueter les images selon les exigences
- Accès à des camions pleins de données historiques
Ensembles de données de formation d'image professionnelle
N'importe quel sujet. N'importe quel scénario.
Les applications qui nécessitent un marquage facial et gestuel ne peuvent pas être alimentées en informations, de manière superficielle. Au lieu de cela, la collecte de données d'images pour les modèles d'apprentissage automatique doit être conforme aux normes les plus récentes. Chez Shaip, nous nous concentrons sur la fourniture d'un accès à des ensembles de données complets de formation d'images avec une assistance de niveau expert vers l'évolutivité.
Les jeux de données d'entraînement d'images professionnels de Shaip se concentrent sur des solutions complètes, incluant le suivi d'entités, l'analyse d'écriture manuscrite, l'identification d'objets et la reconnaissance de formes. Mais ce n'est pas tout ! Les services de collecte de données d'images proposés par Shaip comprennent également :
- Alimentation des données à distance et sur le terrain
- Capacité à faire évoluer les solutions - achat continu d'ensembles de données
- Des données de haute qualité et segmentées prêtes à être exploitées
- Prise en charge de la transcription image-texte pour OCR modèles entraînés
- Prise en charge étendue de l'analyse spécifique à l'homme
- Traitement et gestion sécurisés des données
Notre expertise
Collection d'images qui précède les sujets et les scénarios
Chez Shaip, nous proposons toute une gamme de types de collecte de données d'image, avec des algorithmes synonymes de cas d'utilisation spécifiques. Ajoutez la vision par ordinateur à vos capacités d'apprentissage automatique en collectant de grands volumes d'ensembles de données d'images (ensemble de données d'images médicales, ensemble de données d'images de factures, collecte d'ensembles de données faciales ou tout ensemble de données personnalisé) pour une variété de cas d'utilisation. Chez Shaip, nous proposons toute une gamme de types de collecte de données d'image, avec des algorithmes synonymes de cas d'utilisation spécifiques. Différents types d'ensembles de données d'images que nous proposons :
Collection de documents et d'images OCR
Shaip numérise les factures, reçus, pièces d'identité, passeports et formulaires manuscrits pour la reconnaissance optique de caractères (OCR) et les modèles de compréhension de documents, en plusieurs langues et dans diverses conditions de numérisation. Cas d'utilisation : OCR, vérification d'identité (KYC), classification de documents.
Collection d'images faciales et démographiques
Shaip collecte des ensembles de données d'images faciales couvrant diverses ethnies, âges, positions de la tête et conditions d'éclairage afin de réduire les biais de l'IA, avec des options de points de repère pour la reconnaissance et les modèles émotionnels. Cas d'utilisation : reconnaissance faciale, IA émotionnelle, surveillance des conducteurs de systèmes ADAS.
Collecte de données de santé
Améliorez la qualité de votre configuration numérique de soins de santé et la précision des diagnostics médicaux grâce aux ensembles de données de santé qualitatifs et quantitatifs proposés. Nous fournissons des images médicales, c'est-à-dire tomodensitométrie, IRM, ultrasons, rayons X de diverses spécialités médicales telles que la radiologie, l'oncologie, la pathologie, etc.
Collection d'ensembles de données sur les aliments
Si vous envisagez de développer une application intelligente capable de capturer et d'identifier des images d'aliments, dans différentes conditions d'éclairage, notre collection d'ensembles de données alimentaires peut être très pratique.
Collecte de données automobiles
La formation des bases de données de voitures autonomes avec des éléments en bordure de route, des informations spécifiques à l'angle, des objets, des données sématiques, etc. est possible avec les ensembles de données automobiles.
Collecte de données sur les gestes de la main
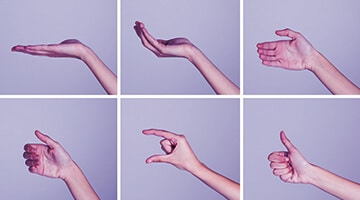
Si vous avez déjà fait glisser votre mobile pour dormir, vous seriez en mesure de comprendre. Les appareils intelligents et IoT avec capteurs peuvent bénéficier de nos services de collecte de données sur les gestes de la main.
Collection d'images d'objets
Notre service de collecte d’images d’objets fournit un large éventail d’images présentant différents objets dans divers contextes et conditions d’éclairage.
Collection d'images de points de repère
Nous sommes spécialisés dans la collecte d’images de monuments du monde entier. Nos ensembles de données couvrent plusieurs angles, heures de la journée et conditions météorologiques.
Collection de textes manuscrits
Collection d'images de texte manuscrites dans diverses langues et styles pour développer des modèles d'IA capables de reconnaître et d'interpréter le texte manuscrit avec précision.
Ensembles de données d'images
Ensemble de données d'image sur le conducteur de voiture
450 20,000 images de visages de conducteurs avec configuration de voiture dans différentes poses et variations couvrant 10 XNUMX participants uniques de plus de XNUMX ethnies
- Cas d'utilisation: Modèle ADAS embarqué
- Format: Images
- Volume: 455,000
- Annotation: Non
Ensemble de données d'images de points de repère
Plus de 80 40 images de points de repère de plus de XNUMX pays, collectées en fonction des exigences personnalisées.
- Cas d'utilisation: Détection de point de repère
- Format: Images
- Volume: 80,000
- Annotation: Non
Ensemble de données d'images faciales
Images 12k avec des variations autour de la pose de la tête, de l'origine ethnique, du sexe, de l'arrière-plan, de l'angle de capture, de l'âge, etc. avec 68 points de repère
- Cas d'utilisation: La reconnaissance faciale
- Format: Images
- Volume: 12,000
- Annotation: Annotation de point de repère
Ensemble de données d'images d'aliments
55 50 images dans plus de XNUMX variations (type d'aliments, éclairage, intérieur vs extérieur, arrière-plan, distance de la caméra, etc.) avec des images annotées
- Cas d'utilisation: Reconnaissance alimentaire
- Format: Images
- Volume: 55,000
- Annotation: Oui
Fonctionnement / Processus
Portée et spécifications
Définir le sujet, le volume, les zones géographiques, les données démographiques, les formats et les exigences en matière de consentement.

Pilotage et étalonnage
Mener un projet pilote à petite échelle pour valider les lignes directrices et les cas particuliers avant de passer à l'échelle supérieure.
Collection complète
Capturez des données en masse grâce au réseau mondial de contributeurs agréés de Shaip.

Assurance qualité Six Sigma
Validation en plusieurs étapes, tâches de référence et contrôles de conformité sur chaque lot.
Livraison et rafraîchissement
Fournissez les données dans votre format avec les métadonnées, puis étendez la couverture selon vos besoins.
Pourquoi choisir Shaip
Personnalisées, non récupérées : Shaip collecte des images récentes et entièrement consenties, correspondant exactement à vos spécifications (domaine, résolution et profil démographique), au lieu de réutiliser des ensembles publics.
Qualité Six Sigma : Une équipe dédiée de ceintures noires Six Sigma gère un processus d’assurance qualité par étapes avec des boucles de rétroaction continues, afin que les ensembles de données soient validés avant leur livraison.
Couverture tenant compte des biais : Shaip utilise des sources couvrant différentes ethnies, âges, zones géographiques et conditions d’éclairage afin de réduire les biais visuels de l’IA au niveau des données.
Services proposés
La collecte de données textuelles par des experts n'est pas un jeu d'enfant pour les configurations complètes de l'IA. Chez Shaip, vous pouvez même envisager les services suivants pour rendre les modèles beaucoup plus répandus que d'habitude :

Services de collecte de données audio
Nous vous permettons d'alimenter plus facilement les modèles avec des données vocales pour les aider à explorer les avantages du traitement du langage naturel de manière plus équilibrée

Services de collecte de données textuelles
La vraie valeur des services de collecte de données cognitives de Shaip est qu'ils donnent aux organisations la clé pour déverrouiller les informations critiques trouvées dans les données non structurées

Services de collecte de données vidéo
Concentrez-vous maintenant sur la vision par ordinateur avec la PNL pour entraîner vos modèles à identifier les objets, les individus, les dissuasifs et autres éléments visuels à la perfection
Ressources recommandées
Guide de l'acheteur
Annotation et étiquetage d'images pour la vision par ordinateur
La vision par ordinateur consiste à donner un sens au monde visuel pour former des applications de vision par ordinateur. Son succès se résume entièrement à ce que nous appelons l'annotation d'images - le processus fondamental derrière la technologie qui permet aux machines de prendre des décisions intelligentes et c'est exactement ce que nous sommes sur le point de discuter et d'explorer.
Solutions
Services et solutions de vision par ordinateur
La vision par ordinateur est un domaine de l'intelligence artificielle qui permet aux machines de voir, de comprendre et d'interpréter le monde visuel comme le font les humains. Elle contribue au développement de modèles d'apprentissage automatique capables de comprendre, d'identifier et de classifier avec précision les objets d'une image ou d'une vidéo, à une échelle et une vitesse bien supérieures.
Blog
Types d'annotations d'images : avantages, inconvénients et cas d'utilisation
Le monde n'est plus le même depuis que les ordinateurs ont commencé à regarder les objets et à les interpréter. Des éléments divertissants qui pourraient être aussi simples qu'un filtre Snapchat qui produit une drôle de barbe sur votre visage aux systèmes complexes qui détectent de manière autonome la présence de minuscules tumeurs à partir de rapports d'analyse, la vision par ordinateur joue un rôle majeur dans l'évolution de l'humanité.
Clients en vedette
Donner aux équipes les moyens de créer des produits d'IA de pointe.
Vous souhaitez créer votre propre référentiel d'ensembles de données d'images ?
Obtenez une vue d'ensemble sur les ensembles de données de formation d'images et procurez-vous un référentiel pour votre modèle de vision par ordinateur.
Questions fréquentes
La collecte de données d'images pour l'IA/ML consiste à rassembler des données visuelles (photographies, numérisations ou graphiques) afin d'entraîner, de tester et de valider des modèles d'apprentissage automatique qui interprètent les images. Les images collectées fournissent aux systèmes de vision par ordinateur les exemples nécessaires pour reconnaître avec précision des objets, des visages, des scènes et des motifs dans des conditions réelles.
La collecte de données d'images commence par la définition des exigences et des objectifs du projet. Les images sont ensuite extraites de bases de données, capturées directement avec des appareils photo ou générées à la demande, la diversité et la qualité étant prioritaires. Une fois collectées, les images sont généralement étiquetées ou annotées afin d'ajouter le contexte et la classification nécessaires à l'entraînement d'un modèle d'apprentissage automatique.
La collecte de données d'images est essentielle à tout projet d'apprentissage automatique traitant d'informations visuelles. Des ensembles de données d'images de qualité et diversifiés permettent un entraînement plus précis et robuste des modèles, ce qui se traduit par de meilleures performances en situation réelle. Des données bien collectées garantissent que les systèmes d'IA peuvent reconnaître, interpréter et réagir de manière fiable aux signaux visuels, quelles que soient les conditions auxquelles ils seront confrontés en production.
En fonction de l'objectif, différents types de données peuvent être collectés : photographies, images satellites, documents manuscrits et numérisés, photographies faciales, images thermiques et captures AR/VR. Le type de données utilisé doit correspondre aux exigences spécifiques du projet d'IA/ML, car la pertinence du domaine influe directement sur la précision du modèle.
La collecte personnalisée permet de capturer des images récentes et entièrement consenties, adaptées au domaine, à la résolution et aux besoins démographiques de votre modèle. Les jeux de données publics comme ImageNet ou COCO sont génériques et ne permettent souvent de développer un modèle qu'au stade de prototype. Shaip collecte les données selon vos spécifications exactes, afin qu'elles reflètent les conditions réelles, les sujets et les cas particuliers que votre application doit gérer.
Shaip applique une démarche qualité Six Sigma par étapes, pilotée par des responsables de processus certifiés, avec des boucles de validation et de retour d'information pour chaque lot. Afin de réduire les biais visuels de l'IA au niveau des données, Shaip utilise des sources variées en termes d'origine ethnique, d'âge, de situation géographique et de conditions d'éclairage, garantissant ainsi des performances équitables et constantes des modèles, sans surreprésentation de certains groupes.
Oui. Shaip collecte les données d'images en obtenant le consentement éclairé des personnes concernées, grâce à des autorisations documentées et à un traitement et un transfert sécurisés et contrôlés. Ceci est essentiel pour un usage commercial, car les images publiques dont la licence est ambiguë peuvent engendrer des risques juridiques.
Le coût dépend du volume et du type d'images, des zones ciblées, des métadonnées requises et des exigences en matière de consentement ; il n'y a donc pas de tarif fixe. Shaip vous propose un devis personnalisé après un bref échange concernant votre sujet, vos spécifications et votre calendrier, ce qui vous évite de payer pour des prestations dont votre modèle n'a pas réellement besoin.