Services de collecte de données d'IA pour l'entraînement des modèles d'apprentissage automatique

Ensembles de données personnalisés (texte, image, audio et vidéo) — fournis par 500 000 contributeurs vérifiés dans plus de 150 langues.
Prestations de collecte de données
Google Microsoft Services Web Amazon

Services de collecte de données entièrement gérés

Les données étant de la plus haute importance pour le succès de chaque organisation, on estime qu'en moyenne, les équipes d'IA passent 80 % de leur temps à préparer les données pour les modèles d'IA.

L'équipe Shaip, grâce à notre outil propriétaire de collecte de données (application mobile disponible pour Android et iOS), gère un réseau mondial de collecteurs de données pour recueillir les données d'entraînement nécessaires à vos projets d'IA et d'apprentissage automatique. Nos outils d'IA simplifient la collecte et l'organisation des données, permettant une intégration et une collaboration fluides entre les plateformes. En puisant dans une grande diversité de groupes d'âge, de profils démographiques et de niveaux d'éducation, nous vous aidons à collecter d'importants volumes de données d'apprentissage automatique pour répondre aux exigences des initiatives d'IA les plus pointues. Shaip vous accompagne tout au long du processus de collecte de données, en insistant sur l'importance de processus optimisés pour développer, déployer et gérer avec succès vos projets d'IA. Vous pouvez ainsi vous concentrer sur les résultats et faire progresser votre projet d'IA dans une direction claire.

Notre communauté

Nous fournissons des données de formation d'IA collectées, annotées et validées par notre communauté active, contrôlée et qualifiée de spécialistes des données d'IA, adaptées aux exigences spécifiques de votre projet d'apprentissage automatique.

Contributeurs à grande échelle
0 +
main-d'œuvre mondiale interne
0 +
Langues et dialectes
0 +
Pays
0 +

Qu’est-ce que la collecte de données IA ?

La collecte de données pour l'IA consiste à rassembler et préparer de grands volumes de données textuelles, d'images, audio et vidéo utilisées pour l'entraînement des modèles d'apprentissage automatique. Shaip propose des services de collecte de données pour l'IA entièrement gérés, en s'appuyant sur une communauté mondiale de 500 000 contributeurs vérifiés, couvrant plus de 150 langues, pour constituer des ensembles de données personnalisés. Ces ensembles incluent l'annotation, la validation et la conformité réglementaire.

Solutions professionnelles de collecte de données

N'importe quel sujet. N'importe quel scénario.

Du suivi des interactions humaines à la collecte d'images faciales en passant par la mesure des sentiments, notre solution offre des ensembles de données de machine learning essentiels aux entreprises souhaitant entraîner leurs modèles de machine learning. Nous nous concentrons sur la collecte de points de données provenant de sources diverses afin d'améliorer la précision et la réutilisabilité des modèles dans différentes applications. En tant que leader des services de collecte de données, nous aidons nos clients à générer d'importants volumes de données d'entraînement de haute qualité, issues de différents types de données, pour gérer des projets d'IA complexes avec des configurations de scénarios uniques et des annotations complexes, essentielles à un entraînement complet des modèles d'IA.

Qu'il s'agisse d'un projet ponctuel ou que vous ayez besoin de données de manière continue, notre équipe expérimentée de chefs de projet veille à ce que l'ensemble du processus se déroule sans heurts.

Types de données d'IA fournies

Données textuelles
Données vocales
Données d'image
Données vidéo
Solutions professionnelles de collecte de données

Ensembles de données de texte pour le traitement du langage naturel

Le véritable atout des services de collecte de données textuelles cognitives Shaip réside dans le fait qu'ils permettent aux organisations d'accéder aux informations critiques contenues dans les données textuelles non structurées. Lorsque les données entrantes arrivent sous forme de texte non structuré, elles sont analysées afin d'identifier des tendances et d'en extraire des informations précieuses pour les applications de traitement automatique du langage naturel (TALN). Ces données non structurées peuvent inclure des notes médicales, des déclarations de sinistres habitation ou des relevés bancaires. La collecte d'un volume important de données textuelles est essentielle au développement de technologies capables de comprendre le langage humain. Nos services couvrent une grande variété de services de collecte de données textuelles pour créer des ensembles de données TALN de haute qualité.

Collecte de données textuelles

Services de collecte de données textuelles

Développez le traitement du langage naturel avec la collecte de données textuelles multilingues spécifiques au domaine (ensemble de données de carte de visite, ensemble de données de document, ensemble de données de menu, ensemble de données de reçu, ensemble de données de ticket, messages texte) pour déverrouiller les informations critiques trouvées profondément dans les données non structurées pour résoudre une variété de cas d'utilisation. En tant qu'entreprise de collecte de données textuelles, Shaip propose différents types de services de collecte et d'annotation de données. Tel que:

En savoir plus ➔

Collecte d'ensembles de données de réception

Collecte des données de réception

Nous vous aidons à collecter différents types de factures telles que des factures Internet, des factures d'achat, des reçus de taxi, des factures d'hôtel, etc. de partout dans le monde et dans les langues requises.
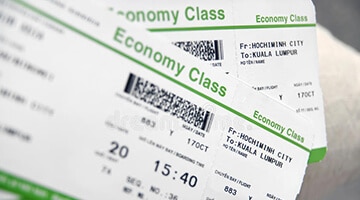
Collecte d'ensembles de données de tickets

Collection d'ensembles de données de billets

Nous vous aidons à trouver différents types de billets, c'est-à-dire des billets d'avion, des billets de train, des billets de bus, des billets de croisière, etc. du monde entier en fonction de vos spécifications personnalisées.

Collecte de données Ehr

Données DSE et transcriptions des dictées des médecins

Nous pouvons vous offrir des données de DSE et des transcriptions de dictée de médecin prêtes à l'emploi de diverses spécialités médicales, c'est-à-dire la radiologie, l'oncologie, la pathologie, etc.
Collecte d'ensembles de données documentaires

Collection d'ensembles de données de documents

Nous pouvons vous aider à collecter tous les types de documents importants - tels que les permis de conduire, les cartes de crédit, de différentes zones géographiques et langues - selon les besoins pour former les modèles ML.

Ensembles de données vocales pour le traitement du langage naturel

Shaip propose des services complets de collecte de données vocales et audio dans plus de 150 langues, permettant aux technologies vocales de répondre aux besoins d'un public diversifié à travers le monde. La collecte continue de données actualisées est essentielle pour garantir la pertinence et l'exactitude des ensembles de données vocales pour les applications TALN en constante évolution. Nous intervenons sur des projets de toute envergure et de toute taille : de l'acquisition de licences pour des ensembles de données audio standard à la gestion de collectes audio personnalisées, en passant par la transcription et l'annotation audio. L'intégration de données vocales nouvelles et diversifiées permet d'améliorer les modèles existants, garantissant ainsi de meilleures performances et une plus grande adaptabilité. Quelle que soit l'ampleur de votre projet de collecte de données vocales, nous pouvons personnaliser les services de collecte audio en fonction de vos besoins afin de créer des ensembles de données TALN de haute qualité.

Services de collecte de données vocales

Nous sommes un leader en matière de collecte de données vocales/audio pour la formation et l'amélioration de l'IA conversationnelle et des chatbots. Nous pouvons vous aider à collecter des données dans plus de 150 langues et dialectes, accents, régions et types de voix, puis à les transcrire (avec des énoncés), à les horodater et à les catégoriser. Différents types de services de collecte et d'annotation de données vocales que nous proposons :

En savoir plus ➔

Discours monologue

Collection de discours monologues

Collectez des données vocales scriptées, guidées ou spontanées auprès de chaque locuteur. Le locuteur est sélectionné en fonction de vos besoins spécifiques : âge, sexe, origine ethnique, dialecte, langue, etc.

Discours dialogué

Collection de discours de dialogue

Collectez des ensembles de données vocales guidées ou spontanées / interaction entre un agent de centre d'appels et un appelant ou un appelant et un robot en fonction des exigences personnalisées ou comme spécifié dans le projet.

Discours acoustique

Collecte de données acoustiques

Nous pouvons enregistrer de manière professionnelle des données audio de qualité studio, qu'il s'agisse de restaurants, de bureaux ou de maisons ou à partir de divers environnements et langues, grâce à notre réseau mondial de collaborateurs.
Énonciation en langage naturel

Collection d'énoncés en langage naturel

Shaip possède une riche expérience dans la collecte de divers énoncés en langage naturel pour former des systèmes ML audio avec des échantillons de parole dans plus de 100 langues et dialectes de locuteurs locaux et distants.

Ensembles de données d'images pour la vision par ordinateur

La qualité d'un modèle de machine learning (ML) dépend de ses données d'entraînement ; c'est pourquoi nous nous efforçons de vous fournir les meilleurs jeux de données d'images pour vos modèles de ML. Ces jeux de données sont essentiels à l'entraînement des modèles d'IA et des algorithmes de machine learning pour les applications de vision par ordinateur, permettant des prédictions précises basées sur les données et un déploiement en conditions réelles. Notre outil de collecte de données d'images assurera la réussite de vos projets de vision par ordinateur. Nos experts peuvent collecter du contenu image pour toutes les spécifications et situations que vous nous confierez.

Services de collecte de données d'images

Ajoutez la vision par ordinateur à vos capacités d'apprentissage automatique en collectant de grands volumes d'ensembles de données d'images (ensemble de données d'images médicales, ensemble de données d'images de facture, collection d'ensembles de données faciales ou tout ensemble de données personnalisé) pour une variété de cas d'utilisation, par exemple la classification d'images, la segmentation d'images, la reconnaissance faciale , etc. Différents types de services de collecte et d'annotation de données d'images que nous proposons :

En savoir plus ➔

Annotation du document financier

Collection d'ensembles de données de documents

Nous fournissons des ensembles de données d'images de divers documents, c'est-à-dire permis de conduire, carte d'identité, carte de crédit, facture, reçu, menu, passeport, etc.

La reconnaissance faciale

Collection d'ensembles de données faciales

Nous proposons une variété d'ensembles de données d'images faciales constitués de traits et d'expressions du visage, collectés auprès de personnes de plusieurs ethnies, âges, sexes, etc.
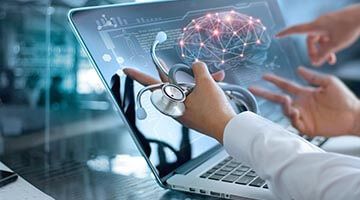
Licence de données médicales

Collecte de données de santé

Nous fournissons des images médicales, c'est-à-dire CT Scan, IRM, échographie, radiographie de diverses spécialités médicales telles que la radiologie, l'oncologie, la pathologie, etc.
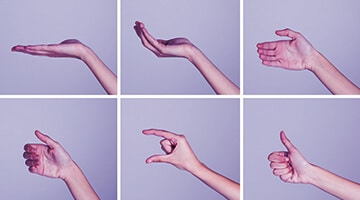
Geste de la main

Collecte de données sur les gestes de la main

Nous proposons des ensembles de données d'images de divers gestes de la main de personnes du monde entier, de plusieurs ethnies, groupes d'âge, sexe, etc.

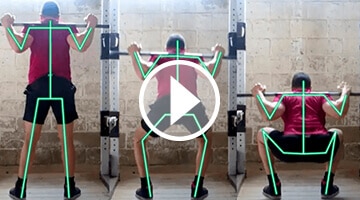
Ensembles de données vidéo pour la vision par ordinateur

Nous vous aidons à capturer chaque objet dans une vidéo image par image. Nous le filmons ensuite en mouvement, l'étiquetons et le rendons reconnaissable par les machines. La collecte de données vidéo de qualité pour entraîner vos modèles de machine learning a toujours été un processus rigoureux et chronophage, la diversité et les quantités massives requises ajoutant à la complexité. Chez Shaip, nous vous offrons l'expertise, les connaissances, les ressources et l'évolutivité nécessaires en matière de services de collecte de données vidéo. Nos vidéos sont de la plus haute qualité et adaptées à votre cas d'utilisation spécifique, avec des jeux de données vidéo conçus pour entraîner des modèles pour des tâches spécifiques en vision par ordinateur.

Services de collecte de données vidéo

Collectez des jeux de données vidéo de formation exploitables, comme des images de vidéosurveillance, des vidéos de circulation, des vidéos de surveillance, etc., pour entraîner des modèles de machine learning. Chaque jeu de données est personnalisé pour répondre précisément à vos besoins. Grâce à notre outil de collecte de données vidéo, nous proposons des services de collecte et d'annotation pour différents types de données :

En savoir plus ➔

Vidéo sur la posture humaine

Collection d'ensembles de données vidéo sur la posture humaine

Nous proposons des ensembles de données vidéo de diverses postures humaines comme marcher, s'asseoir, dormir, etc. dans différentes conditions d'éclairage et différents groupes d'âge.

Drones & vidéo aérienne

Collection de données de drones et de vidéos aériennes

Nous proposons des données vidéo avec une vue aérienne à l'aide de drones pour différentes instances telles que la circulation, le stade, la foule, etc.
Surveillance vidéosurveillance

Ensemble de données vidéo CCTV/surveillance

Nous pouvons collecter des vidéos de surveillance à partir de caméras de sécurité pour que les forces de l'ordre puissent former et identifier une personne ayant des antécédents criminels.

Ensemble de données vidéo sur le trafic

Collection d'ensembles de données vidéo sur le trafic

Nous pouvons collecter des données de trafic à partir de plusieurs emplacements dans différentes conditions d'éclairage et d'intensité pour former vos modèles ML.
Services de collecte de données sur mesure

Services de collecte de données sur site

Services de collecte de données sur site

Besoin de données collectées à l'endroit souhaité ? Nous proposons des services de collecte de données sur site personnalisés, avec des solutions de crowdsourcing personnalisées qui répondent à vos besoins spécifiques.

  • Collecte de données biométriques sur place
  • Collecte de données vocales sur le terrain
  • Projets d'annotation et d'étiquetage sur site
Collecte de données participative

Collecte de données participative

Vous recherchez des ensembles de données diversifiés et à grande échelle ? Notre réseau mondial de crowdsourcing fournit des solutions de collecte de données rapides, évolutives et diversifiées, idéales pour les projets qui nécessitent des apports variés.

  • Enregistrements de commandes vocales et de mots d'éveil
  • Capture d'images d'objets et de produits
  • Enregistrement vidéo de l'activité humaine
Collecte de données spécifiques à l'appareil

Collecte de données spécifiques à l'appareil

Vous avez besoin de données adaptées à votre technologie unique ? Nous sommes spécialisés dans la collecte de données à partir d'appareils spécifiques pour garantir des entrées précises et pertinentes pour vos besoins en IA et en machine learning.

  • Capture d'images à partir d'appareils mobiles spécifiques
  • Collecte de données vidéo à l'aide de caméras personnalisées
Collecte de données spécifiques à l'environnement

Collecte de données spécifiques à l'environnement

Vous avez besoin de données issues d'environnements contrôlés ou uniques ? Nous collectons des ensembles de données contextuellement riches à partir de paramètres spécifiques pour répondre à vos besoins spécifiques.

  • Enregistrement vocal en studio
  • Collecte de données vocales dans des environnements bruyants
  • Collecte de données vidéo à bord du véhicule
Notre expertise de l'industrie

Les services de collecte de données par IA aident ces secteurs à améliorer l'expérience client en proposant des solutions personnalisées et performantes, comme le traitement des données en temps réel et l'automatisation basée sur l'IA. Grâce à une collecte de données avancée par IA, les entreprises peuvent conserver leur avantage concurrentiel grâce à l'innovation et à une prise de décision optimisée. Nos services de collecte de données avec intervention humaine fournissent des données d'entraînement de haute qualité pour des secteurs tels que…

Technologie

Technologie

Santé

Santé

Mode et e-commerce – étiquetage des images

Vente au détail

Véhicules autonomes

Automobile

Institutions

Services financiers

Gouvernement

Gouvernement

Pourquoi choisir Shaip plutôt que d'autres sociétés de collecte de données

Pour déployer efficacement votre initiative d'IA, vous aurez besoin d'importants volumes de données d'entraînement spécialisées. Shaip applique des pratiques de gestion rigoureuses pour garantir l'organisation, le stockage et la récupération efficaces des données pour les projets d'IA et de ML. Shaip est l'une des rares entreprises du marché à garantir des données d'entraînement d'IA fiables et de premier ordre, à grande échelle et conformes aux exigences réglementaires et au RGPD.

Capacités de collecte de données

Créez, organisez et collectez des ensembles de données personnalisés (texte, parole, image, vidéo) du monde entier en fonction de directives personnalisées.

Main-d'œuvre mondiale flexible

Tirez parti de plus de 10 000 collaborateurs internes à l’échelle mondiale et de plus de 500 000 contributeurs certifiés via CrowdScreen. Suivi en temps réel de la capacité et de l’efficacité de vos équipes.

Qualité

Notre plateforme exclusive et notre main-d'œuvre qualifiée utilisent plusieurs méthodes de contrôle qualité pour atteindre ou dépasser les normes de qualité.

Divers, précis et rapide

Notre processus simplifie la collecte des données grâce à une répartition plus facile des tâches et à la capture directe des données depuis l'application et le web.

Sécurité des données

Maintenez la confidentialité complète des données en faisant de la confidentialité notre priorité. Nous nous assurons que les formats de données sont contrôlés et préservés par la politique

Annotation de bout en bout

Chaque ensemble de données collectées peut être annoté, étiqueté, transcrit et validé dans le même flux de travail, fournissant ainsi des données d'entraînement prêtes à l'emploi pour le modèle.

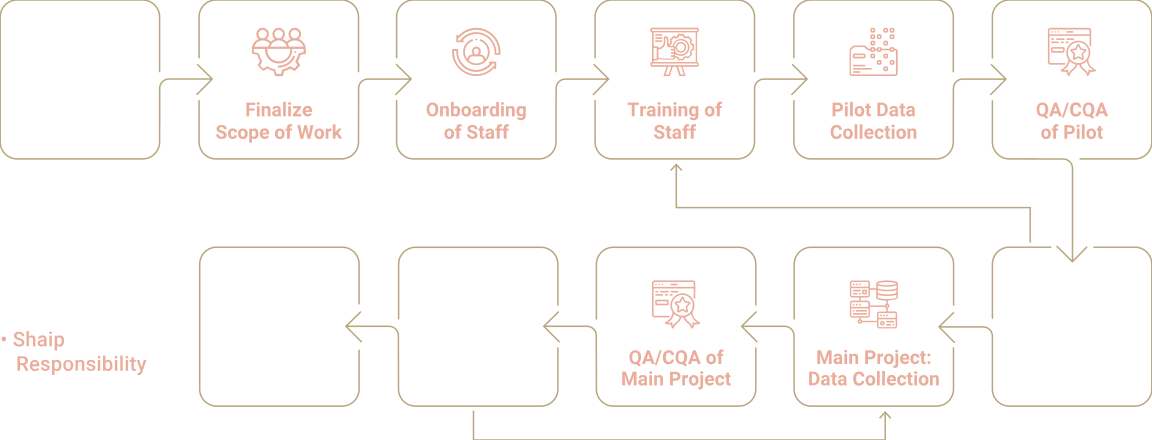
Processus de collecte de données

La collecte de données est un élément fondamental du développement de solutions d'intelligence artificielle (IA) et d'apprentissage automatique (AA). Elle débute par l'identification et l'acquisition de données pertinentes selon deux approches principales : la collecte de données sur mesure et l'exploitation de sources de données existantes . La collecte sur mesure implique le recours à des freelances, au crowdsourcing, aux équipes internes et aux enquêteurs de terrain pour recueillir des données adaptées aux exigences spécifiques de chaque projet. Quant aux données existantes, elles peuvent provenir de bases de données internes, de référentiels de données externes, de plateformes de médias sociaux et du web scraping de contenus publics. Dans certains cas, les organisations peuvent également utiliser des données synthétiques générées par l'IA pour enrichir et diversifier leurs ensembles de données réelles.

Un aspect essentiel de ce processus consiste à garantir l'exactitude des données dès le départ, car la qualité des données collectées influence directement l'efficacité des modèles d'IA. Une fois les données collectées, elles sont soumises à un prétraitement : une série d'étapes comprenant le nettoyage, la transformation et l'organisation des données brutes. Cette étape est essentielle pour éliminer le bruit, traiter les valeurs manquantes et standardiser les formats de données, rendant ainsi les informations exploitables par les algorithmes d'IA.
Processus de collecte de données

Outils de collecte de données

L'outil propriétaire de collecte de données ShaipCloud est conçu pour simplifier la répartition des tâches entre les équipes internationales de collecteurs de données. Son interface permet aux prestataires de services de collecte et d'annotation de données de consulter facilement leurs tâches, d'examiner les directives détaillées du projet (avec exemples) et de soumettre rapidement les données pour approbation par les auditeurs. L'application est disponible sur le Web, Android et iOS.

Spécialité : catalogues de données et licences

Ensembles de données de santé/médicales

Nos ensembles de données cliniques anonymisées comprennent des données provenant de 31 spécialités différentes, à savoir la cardiologie, la radiologie, la neurologie, etc.

Afficher l'ensemble de données

Ensembles de données vocales/audio

Source de données vocales de haute qualité dans plus de 60 langues

Afficher l'ensemble de données

Ensemble de données de vision par ordinateur

Ensembles de données d'images et de vidéos pour accélérer le développement de ML.

Afficher l'ensemble de données

Sécurité et conformité

GDPR
HIPAA
ISO 9001: 2015
SOC2 Type II
ISO 27001
Shaip nous contacter

Vous souhaitez créer votre propre ensemble de données ?

Contactez-nous maintenant pour savoir comment nous pouvons collecter un ensemble de données personnalisé pour votre solution d'IA unique.

  • Ce champ est à des fins de validation et devrait être laissé inchangé.
  • En m'inscrivant, je suis d'accord avec Shaip Politique de confidentialité et Conditions d’utilisation et donner mon consentement pour recevoir des communications marketing B2B de Shaip.

La collecte de données pour l'IA consiste à rassembler et à préparer de grands volumes de données textuelles, d'images, audio et vidéo utilisées pour entraîner les modèles d'apprentissage automatique. Elle est essentielle car la précision, l'équité et la fiabilité des modèles dépendent de jeux de données diversifiés, de haute qualité et bien étiquetés, qui permettent aux modèles de reconnaître des schémas et d'effectuer des prédictions exactes.

Shaip garantit la qualité grâce à des contributeurs qualifiés et rigoureusement sélectionnés, à sa plateforme propriétaire ShaipCloud et à un contrôle qualité en plusieurs étapes réalisé par des auditeurs formés. Chaque jeu de données est validé, nettoyé et annoté afin d'en vérifier l'exactitude, la diversité et la conformité avant sa livraison.

Oui. Shaip collecte et traite les données conformément au RGPD, à la loi HIPAA et aux réglementations régionales applicables en matière de protection de la vie privée. Chaque projet inclut la gestion du consentement, l'anonymisation des données personnelles et des contrôles stricts de confidentialité intégrés au flux de travail.

Shaip réduit les biais dans les données en utilisant des ensembles de données diversifiés couvrant des critères démographiques, géographiques, linguistiques et dialectaux. Un échantillonnage équilibré et un contrôle qualité rigoureux garantissent que les données d'entraînement reflètent la réalité, permettant ainsi d'élaborer des modèles plus justes et plus précis.

Oui. Shaip crée des ensembles de données personnalisés répondant précisément à vos spécifications, notamment en ce qui concerne les données démographiques cibles, les langues, les environnements et les cas particuliers, pour les textes, les images, l'audio et la vidéo. Les ensembles de données sont collectés de A à Z lorsque les données disponibles dans le commerce ne répondent pas aux exigences de votre modèle.

Oui. Shaip propose des services de collecte sur site et sur le terrain, incluant des données biométriques, des enregistrements vocaux et des ensembles de données spécifiques à l'environnement, capturés dans des contextes réels tels que des studios, des véhicules et des lieux bruyants.

Le coût dépend du type de données, de leur volume, de leur complexité et de leur personnalisation. Shaip ne publie pas de tarifs fixes ; contactez-nous pour obtenir un devis adapté à votre projet d’IA.

Les entreprises collectent des ensembles de données d'IA par le biais de collectes personnalisées (collecte participative, collecte sur le terrain ou équipes internes) ou en acquérant des licences auprès de sources existantes. Les données sont ensuite prétraitées, validées et annotées pour l'entraînement des modèles. Shaip gère l'intégralité de ce processus via la plateforme ShaipCloud.

L'externalisation auprès de Shaip permet de gagner du temps d'ingénierie, garantit la qualité grâce à une assurance qualité experte et vous donne accès à une main-d'œuvre mondiale interne de plus de 10 000 personnes et à plus de 500 000 contributeurs à l'échelle de la foule, fournissant des données diversifiées et prêtes à être modélisées en toute sécurité sans avoir à développer de capacité de collecte en interne.

Oui. Shaip s'appuie sur une main-d'œuvre interne de plus de 10 000 personnes à l'échelle mondiale et sur plus de 500 000 contributeurs externes pour obtenir rapidement des ensembles de données diversifiés et à grande échelle couvrant des données démographiques, linguistiques et régionales.

Oui. Shaip peut enrichir les ensembles de données réelles avec des données synthétiques générées par l'IA et fournir des paires réponse-instantané ainsi que des données RLHF pour affiner les grands modèles de langage et génératifs, ce qui est utile lorsque les données réelles sont rares ou sensibles en matière de confidentialité.

Shaip utilise la plateforme propriétaire ShaipCloud pour gérer la répartition des tâches, l'annotation et le contrôle qualité. Accessible via le web, Android et iOS, elle offre une visibilité en temps réel sur la capacité des équipes et l'avancement des projets.

Oui. Shaip propose des services de bout en bout, incluant l'annotation, l'étiquetage, la transcription et la validation, permettant ainsi aux données collectées d'être directement exploitables pour la modélisation, sans passer par un second prestataire.

Shaip prend en charge la collecte de données dans plus de 150 langues et dialectes, dont l'hindi, l'arabe, l'espagnol, le chinois, l'anglais et le français.