Dans le cadre de nos efforts pour concevoir des solutions d'IA robustes et objectives, il est essentiel de concentrer nos efforts sur l'entraînement des modèles à l'aide d'un ensemble de données représentatif, dynamique et non biaisé. Notre processus de collecte de données est primordial pour le développement de solutions d'IA fiables. À cet égard, la collecte de données d'entraînement par le biais de contributeurs externes constitue un aspect crucial de notre stratégie de collecte.
Dans cet article, nous allons explorer le rôle des travailleurs indépendants, leur impact sur le développement des algorithmes d'apprentissage de l'IA et des modèles d'apprentissage automatique, ainsi que les besoins et les avantages qu'ils apportent à l'ensemble du processus.
Pourquoi les travailleurs participatifs sont-ils nécessaires pour créer des modèles d'IA ?
En tant qu'êtres humains, nous générons des quantités considérables de données, pourtant seule une fraction de ces données collectées est utile. Faute de normes d'évaluation comparative, la plupart des données collectées sont biaisées, présentent de nombreux problèmes de qualité ou ne sont pas représentatives de l'environnement. Face au développement croissant de modèles d'apprentissage automatique et d'apprentissage profond qui exploitent d'immenses volumes de données, le besoin de jeux de données plus performants, plus récents et plus diversifiés se fait de plus en plus sentir.
C'est là que les crowd workers entrent en jeu.
Le crowdsourcing de données consiste à créer un ensemble de données avec la participation de grands groupes de personnes. Les crowd workers infusent l'intelligence humaine dans l'intelligence artificielle.
Les plateformes de crowdsourcing confient des microtâches de collecte et d'annotation de données à un large éventail de personnes. Le crowdsourcing permet aux entreprises d'accéder à une main-d'œuvre massive, dynamique, rentable et évolutive.
La plateforme de crowdsourcing la plus populaire, Amazon Mechanical Turk, a permis de générer 11 000 dialogues entre humains en seulement 15 heures, et a rémunéré les travailleurs à hauteur de 0.35 $ par dialogue. Le recours à des travailleurs indépendants pour une rémunération aussi dérisoire souligne l'importance d'établir des normes éthiques en matière de collecte de données.
Théoriquement, cela ressemble à un plan intelligent, mais ce n'est pas une stratégie facile à exécuter. L'anonymat des travailleurs de la foule a donné lieu à des problèmes de bas salaires, de mépris des droits des travailleurs et de travail de mauvaise qualité ayant un impact sur les performances du modèle d'IA.
Avantages d'avoir des travailleurs de foule pour sourcer les données
En engageant un groupe diversifié de crowd workers, les développeurs de solutions basées sur l'IA peuvent distribuer des micro-tâches et recueillir des observations variées et généralisées rapidement et à un coût relativement faible.
Certains des principaux avantages de l'emploi de crowd workers pour des projets d'IA sont
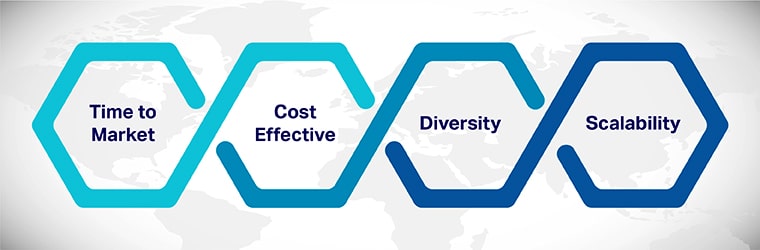
Accélération de la mise sur le marché : selon une étude de Cognilytica, près de 80 % du temps consacré aux projets d’intelligence artificielle est dédié à la collecte de données (nettoyage, étiquetage et agrégation). Seuls 20 % de ce temps sont consacrés au développement et à l’entraînement. Les obstacles traditionnels à la production de données sont levés grâce à la possibilité de recruter rapidement un grand nombre de contributeurs.
Solution économique : La collecte de données participative réduit le temps et l’énergie consacrés à la formation, au recrutement et à l’intégration des contributeurs. Cela permet de réaliser des économies de temps et de ressources, puisque la main-d’œuvre est rémunérée à la tâche.
Amélioration de la diversité des données : La diversité des données est essentielle à l’entraînement des solutions d’IA. Pour qu’un modèle produise des résultats objectifs, il doit être entraîné sur un ensemble de données diversifié. Grâce au crowdsourcing, il est possible de générer des ensembles de données diversifiés (géographiques, linguistiques, dialectaux) à moindre coût et avec peu d’efforts.
Améliore l'évolutivité : en recrutant des travailleurs indépendants fiables, vous pouvez garantir une collecte de données de haute qualité , adaptable aux besoins de votre projet.

In-house vs. crowdsourcing – Qui sort vainqueur ?
| Données internes | Données de crowdsourcing |
|---|---|
| L'exactitude et la cohérence des données peuvent être garanties. | La qualité, l'exactitude et la cohérence des données peuvent être maintenues si des plateformes de crowdsourcing fiables avec des mesures d'AQ standard sont engagées |
| L'approvisionnement en données en interne n'est pas toujours une décision pratique car votre équipe interne peut ne pas répondre aux exigences du projet. | La diversité des données peut être assurée car il est possible de recruter un groupe hétérogène de crowd workers en fonction des besoins du projet. |
| Coûteux pour recruter et former des travailleurs pour les besoins du projet. | Solution économique pour collecte de données car il est possible de recruter, de former et d'intégrer des travailleurs avec moins d'investissement. |
| Le délai de mise sur le marché est élevé car la collecte de données en interne prend un temps considérable. | Le délai de mise sur le marché est nettement inférieur car de nombreuses contributions arrivent rapidement. |
| Un petit groupe de contributeurs et d'étiqueteurs internes | Un groupe important et diversifié de contributeurs et étiqueteurs de données |
| La confidentialité des données est très élevée avec une équipe interne. | La confidentialité des données est difficile à maintenir lorsque l'on travaille avec un grand nombre de travailleurs dans le monde entier. |
| Plus facile de suivre, de former et d'évaluer les collecteurs de données | Difficile de suivre et de former les collecteurs de données. |
Combler le fossé entre les travailleurs du crowdsource et le demandeur.
Il y a un manque flagrant d'informations du côté du demandeur, car les travailleurs ne reçoivent que des informations concernant la tâche spécifique. Par exemple, bien qu'on leur confie des micro-tâches comme l'enregistrement de dialogues dans leur dialecte natif, le contexte leur est rarement fourni. Ils n'ont pas les informations nécessaires pour comprendre le but de leur tâche ni comment l'accomplir au mieux. Ce manque d'informations nuit à la qualité du travail collaboratif.
Pour un être humain, avoir tout le contexte donne de la clarté et un but à son travail.
Ajoutez à ce mélange une autre dimension de la NDA - les accords de non-divulgation qui limitent la quantité d'informations fournies à un crowd worker. Du point de vue du crowdworker, ce retrait d'informations montre un manque de confiance et une diminution de l'importance de leur travail.
Si l'on considère la même situation du point de vue du demandeur, on constate un manque de transparence du côté du travailleur. Ce dernier ne comprend pas pleinement le profil du travailleur chargé de la tâche. Certains projets peuvent exiger un type de travailleur spécifique ; cependant, dans la plupart des cas, l'ambiguïté règne. En réalité , cela peut compliquer l'évaluation, le retour d'information et la formation par la suite.
Pour contrer ces difficultés, il est important de travailler avec des experts en collecte de données ayant fait leurs preuves dans la fourniture de données diverses, organisées et bien représentées à partir d'une large sélection de contributeurs.
Choisir Shaip comme partenaire de données peut avoir de multiples avantages. Nous nous concentrons sur la diversité et la représentativité des distributions de données. Notre personnel expérimenté et dévoué comprend les contraintes de chaque projet et développe des ensembles de données qui peuvent former des solutions robustes basées sur l'IA en un rien de temps.
[À lire également : Guide de démarrage sur les données d’entraînement en IA : définition, exemples, jeux de données ]