Services et solutions de traitement automatique du langage naturel (TALN)

Plus de 30 000 annotateurs en traitement automatique du langage naturel. Plus de 150 langues. Une entreprise du Fortune 500 qui nous fait confiance. Consultation gratuite dès aujourd’hui.
Services de traitement du langage naturel

L'intelligence humaine pour transformer le traitement automatique du langage naturel (TALN) en données de qualité pour l'apprentissage automatique 

Les mots seuls ne parviennent pas à communiquer toute l'histoire. Chez Shaip, nous pouvons vous aider à former vos modèles d'IA pour interpréter l'ambiguïté du langage humain

Depuis un certain temps déjà, on débat de la manière dont l'intelligence artificielle (IA) va transformer tous les aspects de la vie humaine, et vous avez sans doute déjà compris qu'elle a le potentiel d'être la technologie la plus disruptive de tous les temps. Aujourd'hui, nous pouvons interroger Siri, Cortana ou Google pour obtenir des réponses à nos questions les plus courantes, mais une grande partie de leur véritable potentiel reste encore à découvrir.

Développer une IA capable de comprendre véritablement le langage humain exige bien plus que des données brutes : cela requiert des ensembles de données d'entraînement étiquetés avec précision et conçus par des experts linguistiques, fournis à l'échelle de l'entreprise. Shaip est un fournisseur de services NLP de premier plan, offrant des services et des solutions de traitement du langage naturel de bout en bout aux équipes d'IA du monde entier : de la collecte personnalisée de données textuelles et audio à l'annotation par des experts, en passant par des ensembles de données NLP prêts à l'emploi et une gestion complète des ressources humaines pour plus de 150 langues.

Que vous entraîniez un système d'IA conversationnelle, affiniez un modèle de langage complexe (LLM), développiez un moteur d'analyse des sentiments ou mettiez à l'échelle un pipeline de reconnaissance d'entités nommées (NER), les plus de 30 6 collaborateurs certifiés de Shaip fournissent les données d'entraînement NLP structurées et de haute qualité dont vos modèles ont besoin pour fonctionner avec précision en conditions réelles. Utilisées par des entreprises du Fortune 500 dans les secteurs de la santé, de la finance, de la technologie et du commerce de détail, les solutions NLP de Shaip combinent une plateforme propriétaire, des processus qualité Six Sigma et l'expertise de spécialistes du domaine pour répondre aux exigences de précision et de débit de l'IA en production.

Collection de textes audio

Collecte de données NLP — Texte et audio à l'échelle de l'entreprise

Tout modèle de langage performant repose sur des données d'entraînement conçues spécifiquement pour un domaine donné. Les services de collecte de données NLP de Shaip fournissent les données précises dont votre modèle a besoin : en volume, dans votre langue et avec la variabilité linguistique requise par un déploiement en conditions réelles.

Collecte de données textuelles

Nous fournissons des corpus textuels volumineux et personnalisés, couvrant de nombreux formats : courriels, avis clients, publications sur les réseaux sociaux, tickets d’assistance, contrats juridiques, documents financiers, etc. Disponibles dans plus de 150 langues et dialectes régionaux, nos services de collecte de textes permettent d’optimiser l’entraînement des chatbots, le paramétrage des systèmes de recherche, la pertinence des résultats et les processus d’analyse documentaire.

Collecte de données audio et vocales

De la saisie de texte aux dialogues spontanés, Shaip collecte des enregistrements audio de haute qualité, adaptés à vos besoins en reconnaissance automatique de la parole (ASR) ou en intelligence artificielle vocale : accents, environnements sonores, caractéristiques des locuteurs et conditions acoustiques. Les données sont fournies individuellement ou sous forme de packs ASR complets avec transcription, lexiques de prononciation et documentation linguistique pour un entraînement immédiat du modèle. Toutes les données collectées sont livrées avec des métadonnées complètes, l’attribution du locuteur et une vérification de la qualité via la plateforme d’annotation propriétaire de Shaip.

Annotation et étiquetage des données NLP — Précision linguistique experte

Pour être performants, les modèles de traitement automatique du langage naturel (TALN) nécessitent des données d'entraînement annotées avec précision. Les services d'annotation de données de Shaip associent une équipe multilingue qualifiée à une plateforme propriétaire afin de fournir des étiquettes précises et homogènes à grande échelle, grâce à des contrôles qualité intégrés et un suivi transparent de la livraison.

Annotation audio-texte

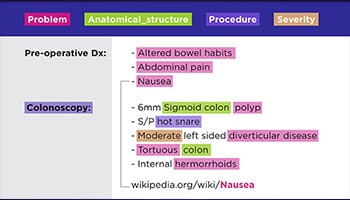
Nos capacités d'annotation NLP couvrent tous les principaux types de tâches :

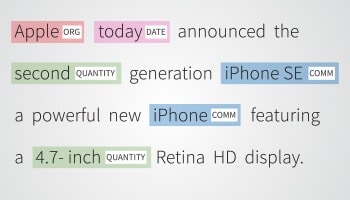
  • Reconnaissance d'entité nommée (NER) : Identifier et classer les personnes, les organisations, les lieux, les dates et les entités spécifiques à un domaine
  • Analyse des sentiments et des intentions : Capturez le ton, l'émotion et l'intention de l'utilisateur à travers les avis, les interactions avec le support et le contenu des réseaux sociaux.
  • Classification et catégorisation des textes : Étiqueter à grande échelle les documents, les sujets et le contenu pour les pipelines d'apprentissage automatique en aval
  • Annotation et étiquetage audio : Segmenter, transcrire et étiqueter les données vocales, y compris la diarisation des locuteurs et la classification des événements acoustiques
  • Extraction des relations : Cartographier les relations entre les entités pour construire des ensembles d'entraînement riches en connaissances pour les modèles NLP basés sur les graphes
  • Étiquetage sémantique des rôles : Identifier la structure prédicat-argument pour les tâches de compréhension approfondie du langage

Toutes les annotations sont réalisées selon un processus qualité en plusieurs étapes 6 Sigma, avec une évaluation de l'accord entre les annotateurs et des boucles de rétroaction continues.

Licence de données

Licence de données : ensembles de données NLP prêts à l'emploi

Parcourez notre ensemble de données audio composé de divers ensembles de données NLP prêts à l'emploi, comprenant plus de 20 000 heures d'audio, sur une variété de sujets tels que les centres d'appels, les conversations générales, les débats, les discours, les conférences, les documentaires, les événements, les films, les actualités, etc., dans plus de 40 langues.

Main-d'œuvre gérée

Nous mettons à votre disposition une ressource qualifiée qui s'intègre à votre équipe pour vous accompagner dans vos tâches d'annotation de données, grâce aux outils de votre choix, tout en garantissant la qualité souhaitée. Nos experts maîtrisent les subtilités du langage humain et appliquent les meilleures pratiques acquises lors de l'annotation de millions de documents audio et textuels afin de vous offrir une solution d'annotation de données de pointe pour le traitement automatique du langage naturel.

Effectif géré

Conseil et mise en œuvre du traitement automatique du langage naturel

Capacités de collecte et d'annotation de texte et audio

De la collecte de textes et d'audio à l'annotation, nous vous offrons une meilleure compréhension du monde parlé grâce à des données textuelles et audio détaillées et étiquetées avec précision, afin d'améliorer les performances de vos modèles de traitement automatique du langage naturel (TALN). Que vous souhaitiez entraîner un assistant virtuel ou numérique, examiner un contrat juridique ou développer un algorithme d'analyse financière, nous vous fournissons les données de référence dont vous avez besoin pour que vos modèles fonctionnent en situation réelle. Notre équipe maîtrise la langue, les dialectes, la syntaxe et la structure des phrases pour étiqueter les textes avec précision, en fonction de vos besoins métiers.

Nous sommes l'une des rares entreprises de PNL à valoriser son expertise linguistique. Notre équipe internationale compte plus de 30 000 collaborateurs à travers le monde, maîtrisant plus de 150 langues . Nous avons accompagné des startups en phase d'amorçage, des PME et des entreprises du Fortune 500 dans divers secteurs (santé, distribution/e-commerce, finance, technologie, etc.) pour les aider à atteindre leurs objectifs en matière de PNL.

Ensembles de données PNL

Ensemble de données d'IA conversationnelle / Ensemble de données audio

Plus de 50 XNUMX heures d'ensembles de données audio/vocaux prêts à l'emploi pour vous aider à démarrer.

Collecte de données pour l'IA conversationnelle

Ensembles de données PNL pour l'analyse des sentiments

Analysez les émotions humaines en interprétant les nuances dans les avis des clients, les médias sociaux, etc.

Analyse des sentiments

Ensemble de données textuelles pour la reconnaissance vocale et les chatbots

Collectez des ensembles de données textuelles, c'est-à-dire des e-mails, des SMS, des blogs, des documents, des articles de recherche, etc.

Ensemble de données texte

Cas d'usage

Formation chatbot

Formation IA conversationnelle / Chatbot

Les assistants numériques de formation nécessitent un grand nombre de données de qualité provenant de différentes zones géographiques, langues, dialectes, configurations et formats. Chez Shaip, nous proposons des données de formation pour les modèles d'IA avec Human-in-the-loop qui ont les connaissances requises, l'expertise du domaine et sont bien conscients des besoins spécifiques du client.

Analyse des sentiments

Analyse des sentiments et des intentions

Il est dit à juste titre que les mots seuls ne parviennent pas à communiquer toute l'histoire, et il incombe aux annotateurs humains d'interpréter l'ambiguïté du langage humain. Par conséquent, l'identification du sentiment d'un client, sur la base de la conversation, est de la plus haute importance. Nos experts linguistiques de divers domaines peuvent interpréter les nuances dans les critiques de produits, les actualités financières et les médias sociaux.

Reconnaissance d'entité nommée (ner)

Reconnaissance des entités nommées (NER)

La reconnaissance des entités nommées (NER) identifie, extrait et classe les entités nommées dans un texte, dans des catégories prédéfinies. Le texte peut être classé en un lieu, un nom, une organisation, un produit, une quantité, une valeur, un pourcentage, etc. Avec NER, vous pouvez répondre à des questions du monde réel telles que les organisations mentionnées dans l'article, etc.

Automatisation du service client

Automatisation du support client

Des chatbots virtuels ou assistants numériques robustes et bien formés ont révolutionné la façon dont les clients communiquent avec les vendeurs, contribuant ainsi à une amélioration significative de l'expérience client.

Transcription audio et texte

Transcription de texte

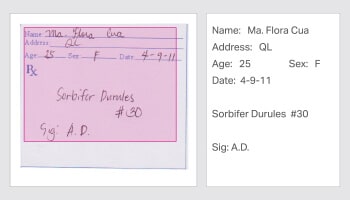
Des ordonnances manuscrites des médecins aux notes de conférence téléphonique, nos spécialistes peuvent numériser toute forme de données, c'est-à-dire des documents archivés, des contrats juridiques, des dossiers de santé des patients, etc.

Catégorisation du contenu

Catégorisation du contenu

La catégorisation, également appelée classification ou étiquetage, consiste à classer le texte en groupes organisés et à l'étiqueter en fonction de ses caractéristiques d'intérêt.

qualité de la traduction automatique

Qualité de la traduction automatique

Évaluation humaine et post-édition des résultats de la traduction automatique pour mesurer la fluidité, l'adéquation et la précision du domaine — permettant des systèmes de TA fiables pour les déploiements multilingues.

Données de réglage fin Llm

Données de réglage fin LLM

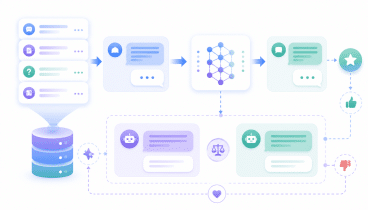
Des ensembles de données de suivi d'instructions soigneusement sélectionnés, des paires invite-réponse et des données de préférence RLHF pour affiner et aligner les grands modèles de langage sur vos exigences en matière de domaine, de ton et de tâche.

Compréhension des documents

Compréhension du document

Annotation de structures de documents complexes (contrats, dossiers médicaux, documents financiers) pour entraîner des modèles d'IA documentaire capables d'extraire, de classer et de raisonner sur des textes non structurés à grande échelle.

Analyse du sujet

Analyse du sujet

L'analyse de sujet ou l'étiquetage de sujet consiste à identifier et à extraire le sens d'un texte donné en identifiant les sujets/thèmes récurrents à l'étude.

Transcription audio

Transcription audio

Transcrivez le discours/podcast/séminaire, appelez la conversation en texte. Tirez parti des humains pour annoter avec précision les fichiers audio/vocaux afin d'entraîner avec précision les modèles NLP.

Classement audio

Classification audio

Catégoriser les sons ou les énoncés pour classer la parole/l'audio en fonction de la langue, du dialecte, de la sémantique, des lexiques, etc.

Pourquoi Shaip ?

Effectif expert

Notre groupe d'experts maîtrisant l'annotation textuelle/audio/l'étiquetage peut obtenir des ensembles de données NLP précis et efficacement annotés.

Focus sur la croissance

Notre équipe vous aide à préparer des données texte/audio pour la formation de moteurs d'IA, ce qui vous fait gagner un temps et des ressources précieux.

Évolutivité

Notre équipe de collaborateurs peut s'adapter à un volume supplémentaire tout en maintenant la qualité de sortie des données pour vos solutions PNL.

Une tarification compétitive

Experts en formation et management d'équipes, nous veillons à ce que les projets soient livrés dans le budget défini.

Capacité intersectorielle

L'équipe analyse les données de plusieurs sources et est capable de produire des données de formation à l'IA de manière efficace et en volume dans tous les secteurs.

Gardez une longueur d'avance sur la concurrence

La large gamme de données audio/texte fournit à l'IA de nombreuses informations nécessaires pour s'entraîner plus rapidement.

Notre capacité

Personnes

Personnes

Des équipes dédiées et formées:

  • Plus de 30,000 collaborateurs pour la création de données, l'étiquetage et le contrôle qualité
  • Équipe de gestion de projet accréditée
  • Équipe de développement de produits expérimentée
  • Équipe d'approvisionnement et d'intégration du pool de talents

Processus

Processus

Une efficacité de processus maximale est assurée avec:

  • Processus robuste 6 Sigma Stage-Gate
  • Une équipe dédiée de ceintures noires 6 Sigma – Responsables des processus clés & Conformité qualité
  • Amélioration continue et boucle de rétroaction

Plateforme complète

Plateforme complète

La plateforme brevetée offre des avantages :

  • Plateforme Web de bout en bout
  • Une qualité irréprochable
  • TAT plus rapide
  • Livraison transparente

Clients en vedette

Donner aux équipes les moyens de créer des produits d'IA de pointe.

Accélérez votre feuille de route en IA grâce aux services de traitement automatique du langage naturel (services NLP) de Shaip.

La PNL est une branche de l’intelligence artificielle qui permet aux machines de comprendre, d’analyser et de répondre au langage humain, à la fois au texte et à la parole, en interprétant le contexte, le sentiment et l’intention.

Le traitement du langage naturel (TALN) consiste à traiter le langage humain à l'aide d'algorithmes analysant la grammaire, la syntaxe, la sémantique et le contexte. Il s'appuie sur de vastes volumes de données annotées pour entraîner les modèles d'IA à extraire du sens, identifier des modèles et générer des réponses précises.

Le TALN est utilisé dans des applications telles que les assistants virtuels, les chatbots, l'analyse des sentiments, la traduction automatique, la synthèse de texte, la détection de spam et la correction grammaticale. Il alimente des systèmes qui rendent les interactions homme-machine plus efficaces et naturelles.

Les services de PNL incluent la collecte de texte (source de données textuelles diverses), la collecte audio (enregistrement de données vocales), l'annotation de données (étiquetage de texte et d'audio pour la formation de l'IA) et la transcription (conversion de la parole en texte pour analyse).

Les solutions de traitement du langage naturel (TALN) améliorent les modèles d'IA en fournissant des ensembles de données étiquetés avec précision qui aident les modèles à mieux comprendre le langage humain. Cela optimise des tâches telles que l'analyse des sentiments, la reconnaissance d'entités nommées (NER), l'IA conversationnelle et l'entraînement des chatbots.

Les secteurs clés comprennent les soins de santé (analyse des dossiers médicaux et du sentiment des patients), la finance (détection des fraudes et analyse des documents) et le commerce électronique (recommandations personnalisées et automatisation du support client).

Les délais varient en fonction de la taille et de la complexité du projet, mais sont optimisés pour fournir des données de haute qualité de manière efficace.

La qualité est garantie par des processus de validation rigoureux, des annotateurs experts et des outils avancés, garantissant que les données répondent aux normes les plus élevées.

Les coûts dépendent de facteurs tels que la portée du projet, la complexité des données et les besoins de personnalisation. Contactez Shaip pour obtenir un devis personnalisé en fonction de vos besoins.

Le traitement automatique du langage naturel (TALN) en tant que service (PaaS) désigne un modèle de livraison de données entièrement géré, où un fournisseur de services TALN prend en charge chaque étape de votre pipeline de données linguistiques (collecte, annotation, assurance qualité et livraison). Shaip propose des modèles de livraison par projet, par abonnement et avec équipe intégrée, afin de répondre aux différents besoins organisationnels et à toutes les envergures de projets.

Chaque groupe linguistique est composé de locuteurs natifs ou quasi natifs recrutés et sélectionnés pour leur expertise du domaine. Les annotations sont calibrées à l'aide d'ensembles de référence de qualité supérieure, et un processus de contrôle qualité en six étapes (Six Sigma) avec évaluation de la concordance inter-annotateurs garantit la cohérence pour toutes les paires de langues et tous les dialectes.

Shaip met en œuvre des flux de travail conformes à la loi HIPAA pour les projets de traitement automatique du langage naturel (TALN) dans le secteur de la santé et respecte les exigences du RGPD en matière de gestion du consentement pour la collecte de données au sein de l'UE. Tous les projets incluent une documentation de traçabilité, des enregistrements de provenance des données et des contrôles d'accès basés sur les rôles pour les équipes de conformité de l'entreprise.

Oui. Shaip fournit des ensembles de données pour le suivi d'instructions, des paires invite-réponse et des données de préférences RLHF pour l'ajustement et l'alignement des modèles de langage. Notre page dédiée aux solutions d'IA générative présente l'ensemble des services de données d'entraînement pour les modèles de langage.

La collecte de données consiste à obtenir des textes ou des fichiers audio bruts, qui constituent le matériel d'entrée à partir duquel votre modèle apprendra. L'annotation consiste à étiqueter ces données brutes avec des balises structurées, des catégories, des entités ou des indicateurs de sentiment qui indiquent au modèle ce qu'il doit comprendre. Shaip propose ces deux services séparément ou sous forme de solution de données NLP intégrée de bout en bout.

Oui. Shaip a collaboré avec des startups en phase de démarrage, des PME et des entreprises du Fortune 500. Nous proposons une grande flexibilité dans la définition du périmètre des projets, des ensembles de données minimums viables pour les prototypes d'IA et des modèles de prestation évolutifs qui s'adaptent à vos besoins d'annotation. Contactez-nous pour un devis personnalisé.