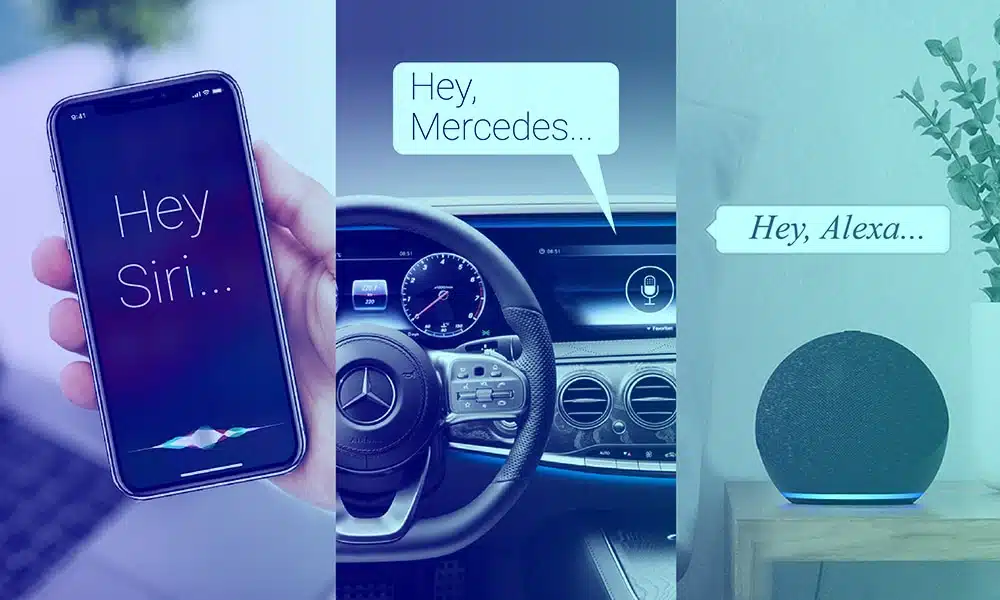
Vous êtes-vous déjà demandé comment les chatbots et les assistants virtuels se réveillent lorsque vous dites « Dis Siri » ou « Alexa » ? C'est en raison de la collecte d'énoncés de texte ou de mots déclencheurs intégrés dans le logiciel qui active le système dès qu'il entend le mot de réveil programmé.
Cependant, le processus global de création de sons et de données d'énoncé n'est pas si simple. C'est un processus qui doit être réalisé avec la bonne technique pour obtenir les résultats souhaités. Par conséquent, ce blog partagera la voie à suivre pour créer de bons énoncés/mots déclencheurs qui fonctionnent de manière transparente avec votre IA conversationnelle.
Qu’est-ce qu’un « énoncé » en IA ?
En IA conversationnelle (chatbots, assistants vocaux), un énoncé est un court extrait de saisie utilisateur : les mots exacts prononcés ou saisis par une personne. Les modèles utilisent ces énoncés pour comprendre l'intention de l'utilisateur (objectif) et ses entités (détails tels que les dates, les noms de produits et les quantités).
Exemples simples
Bot de commerce électronique
Énoncé : « Suivez ma commande 123-456 . »
- Intention : Suivi de la commande
- Entité : order_id = 123-456
Bot télécom
Énoncé : « Mettez à niveau mon forfait de données . »
- Intention : ChangePlan
- Entité : plan_type = données
Assistant vocal bancaire
Énoncé (oral) : « Quel est le solde de mon compte courant aujourd’hui ? »
- Intention : CheckBalance
- Entités : account_type = vérification, date = aujourd'hui
Pourquoi votre IA conversationnelle a besoin de données d'élocution de qualité
Pour que votre chatbot ou assistant vocal soit performant et non rigide, commencez par des données d'énoncés de meilleure qualité. Découvrez comment nous avons procédé dans cette étude de cas sur la collecte d'énoncés : 22 000 heures de collecte dans 13 langues. Les énoncés sont les phrases brutes que les gens prononcent ou écrivent pour accomplir des tâches (« réservez-moi une chambre pour demain », « modifiez mon plan », « quel est le statut ? »). Ils permettent la classification des intentions, l'extraction d'entités et, en fin de compte, l'expérience client. Si vous préférez développer cette solution avec un partenaire, les services de données d'IA conversationnelle de Shaip prennent en charge la collecte, la transcription et l'annotation de bout en bout. Lorsque les énoncés sont diversifiés, représentatifs et bien étiquetés, vos modèles apprennent à distinguer les intentions et à gérer avec aisance les entrées complexes du monde réel.
Créer votre référentiel d'énoncés : un flux de travail simple
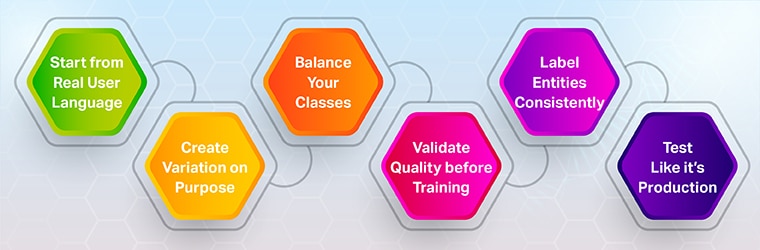
1. Commencez par le langage réel de l'utilisateur
Exploitez les historiques de chat, les requêtes de recherche, les transcriptions des SVI, les notes des agents et les e-mails des clients. Regroupez-les par objectif utilisateur pour identifier les intentions. (Vous découvrirez des expressions familières et des schémas de pensée auxquels vous n'auriez pas pensé en situation réelle.)
2. Créez des variations intentionnelles
Pour chaque intention, l'auteur donne divers exemples :
- Reformulez les verbes et les noms (« annuler », « arrêter », « terminer » ; « planifier », « abonnement »).
- Mélangez les longueurs et les structures des phrases (questionnaire, directive, fragment).
- Incluez les fautes de frappe, les abréviations, les émojis (pour le chat) et les changements de code, le cas échéant.
- Ajoutez des cas négatifs qui semblent similaires mais qui devraient pas carte à cette intention.
3. Équilibrez vos cours
Un entraînement extrêmement déséquilibré (par exemple, 500 exemples pour une intention et seulement 10 pour d'autres) nuit à la qualité des prédictions. Veillez à ce que la taille des intentions soit relativement homogène et augmentez-la progressivement au fur et à mesure que le trafic vous apporte des informations.
4. Valider la qualité avant la formation
Bloquez les données à faible signal avec des validateurs lors de la création/collecte :
- Détection de la langue : s'assurer que les exemples sont dans la langue cible.
- Détecteur de charabia : attraper les chaînes absurdes.
- Contrôles en double/quasi-double : Maintenir une grande variété.
- Regex/orthographe et grammaire : appliquer les règles de style si nécessaire.
Les validateurs intelligents (tels qu'utilisés par Appen) peuvent automatiser une grande partie de ce contrôle.
5. Étiqueter les entités de manière cohérente
Définissez les types d'emplacements (dates, produits, adresses) et indiquez aux annotateurs comment marquer les limites . Des modèles comme « Pattern any » dans LUIS peuvent lever l'ambiguïté des longues séquences variables (par exemple, les noms de documents) qui perturbent les modèles.
6. Testez comme si c'était une production
Transmettez les énoncés réels inédits à un point de terminaison de prédiction ou à un bot de test, examinez les erreurs de classification et intégrez les exemples ambigus à l'entraînement. Créez une boucle : collecte → entraînement → examen → enrichissement.
Ce que signifie réellement la « réalité chaotique » (et comment la gérer)
Les vrais utilisateurs s'expriment rarement avec des phrases parfaites. Attendez-vous à :
- Fragment : « remboursement des frais d'expédition »
- Objectifs composés : « Annuler la commande et commander à nouveau en bleu »
- Entités implicites : « expédier à mon bureau » (vous devez savoir dans quel bureau)
- Ambiguïté: « changer mon plan » (quel plan ? en vigueur quand ?)
Solutions pratiques
- Fournir un clarification des invites seulement quand c'est nécessaire ; évitez de trop demander.
- Capture report de contexte (des pronoms comme « cet ordre », « le dernier »).
- Utilisez le intentions de secours avec une récupération ciblée : « Je peux vous aider à annuler ou à modifier vos plans. Que souhaitez-vous ? »
- Écran tactile intention santé (confusion, collision) et ajouter des données là où elles sont faibles
Assistants vocaux et mots d'activation : des données différentes, des règles similaires
Quand (et comment) utiliser des données standard ou personnalisées
- Sur l'étagère: relancer la couverture dans de nouveaux lieux, puis mesurer où la confusion persiste.
- Encadrement Sur Mesure: capturez le langage de votre domaine (termes de politique, noms de produits) et la « voix de votre marque ».
- Hybride: commencez par une approche large, puis ajoutez des données de haute précision pour les intentions ayant le plus d'impact en termes de déviation ou de revenus.
Si vous avez besoin d'une mise en œuvre rapide, Shaip propose la collecte d'énoncés et des ensembles de données vocales/de conversation prêts à l'emploi dans de nombreuses langues ; consultez l'étude de cas pour le déploiement d'un assistant multilingue.
Check-list de mise en œuvre
- Définir les intentions et les entités avec des exemples et négatif cas
- Auteur varié, équilibré énoncés pour chaque intention (commencer petit, grandir chaque semaine)
- Ajoutez des validateurs (langage, charabia, doublons, expressions régulières) avant l'entraînement
- Mettre en place boucles de révision à partir du trafic réel ; promouvoir les éléments ambigus à la formation
- Piste intention santé et les collisions ; corriger avec de nouvelles expressions
- Réévaluer par canal/local pour détecter rapidement les dérives
Comment Shaip peut vous aider
- Collecte et étiquetage d'énoncés personnalisés (chat + voix) avec des validateurs pour maintenir une qualité élevée.
- Jeux de données prêts à l'emploi dans plus de 150 langues/variantes pour un démarrage rapide.
- Programmes d'examen en cours qui transforment le trafic en direct en données d'entraînement à signal élevé, en toute sécurité (contrôles PII).
Explorez notre étude de cas sur la collecte d'énoncés multilingues.