Ensemble de données de conversations multimodales : l'épine dorsale de l'IA de nouvelle génération
Imaginez discuter avec un ami en appel vidéo. Vous n'entendez pas seulement ses mots ; vous voyez ses expressions, ses gestes, et même les objets qui l'entourent. Ce mélange de différents modes de communication enrichit la conversation, la rend plus humaine et plus efficace.
L'IA évolue dans la même direction. Au lieu de se fier au simple texte, les systèmes avancés doivent combiner texte, images, audio et parfois vidéo pour mieux comprendre et répondre. Au cœur de cette évolution se trouve le corpus de conversations multimodales : une collection structurée de dialogues enrichie de diverses contributions.
Cet article explore ce que sont ces ensembles de données, pourquoi ils sont importants et comment les meilleurs exemples mondiaux façonnent l'avenir des assistants IA, des moteurs de recommandation et des systèmes émotionnellement intelligents.
Qu'est-ce qu'un ensemble de données de conversations multimodales ?
Un ensemble de données de conversations multimodales est une collection de données de dialogue où chaque tour de parole peut inclure plus que du simple texte. Il peut combiner :
Texte (les mots prononcés ou écrits)
Images (photos partagées ou visuels de référence)
Audio (intonation, émotion de la parole ou indices de fond)
Vidéo (gestes, expressions faciales)
Analogie : Imaginez un film avec le son et les sous-titres. Si vous n'aviez qu'un seul mode, l'histoire serait peut-être incomplète. Mais avec les deux, le contexte et le sens sont beaucoup plus clairs.
👉 Pour des définitions claires des concepts d’IA multimodale, consultez notre entrée de glossaire multimodal.
Ensembles de données de conversation multimodales incontournables (paysage concurrentiel)
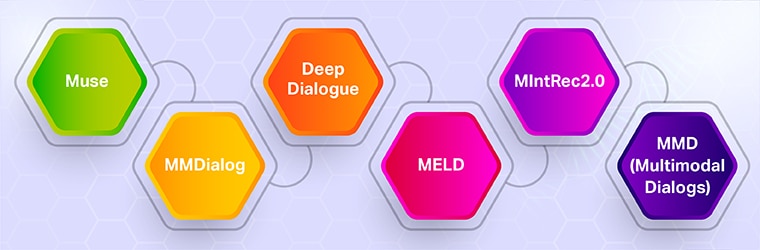
1. Muse – Ensemble de données de recommandation conversationnelle
Points forts: ~7,000 83,148 conversations de recommandations de mode, XNUMX XNUMX énoncés. Générées par des agents multimodaux, basées sur des scénarios réels. Cas d'utilisation: Idéal pour former des stylistes IA ou des assistants commerciaux.
2. MMDialog – Données de dialogue massives en domaine ouvert
Points forts: 1.08 million de dialogues, 1.53 million d'images, répartis sur 4,184 XNUMX sujets. L'un des plus grands ensembles de données multimodales disponibles. Cas d'utilisation: Idéal pour l’IA à usage général, des assistants virtuels aux chatbots à domaine ouvert.
3. DeepDialogue – Conversations riches en émotions (2025)
Points forts: 40,150 41 dialogues à plusieurs tours, 20 domaines, XNUMX catégories d'émotions. Se concentre sur le suivi de la progression émotionnelle. Cas d'utilisation: Concevoir des agents de soutien IA empathiques ou des compagnons de santé mentale.
4. MELD – Reconnaissance multimodale des émotions dans la conversation
Points forts: Plus de 13,000 XNUMX énoncés issus de dialogues d'émissions télévisées (Friends), enrichis de sons et de vidéos. Les mots-clés incluent des émotions comme la joie, la colère et la tristesse. Cas d'utilisation: Systèmes sensibles aux émotions pour la détection et la réponse aux sentiments conversationnels.
5. MIntRec2.0 – Benchmark de reconnaissance d'intention multimodale
Points forts: 1,245 15,040 dialogues, 9,304 5,736 échantillons, avec des étiquettes « intra-sens » (XNUMX XNUMX) et « hors-sens » (XNUMX XNUMX). Inclut le contexte multipartite et la catégorisation des intentions. Cas d'utilisation: Inculquer une solide compréhension de l’intention de l’utilisateur, améliorer la sécurité et la clarté de l’assistant.
6. MMD (dialogues multimodaux) – Conversations d'achat sensibles au domaine
Points forts: Plus de 150 XNUMX sessions entre acheteurs et agents. Échanges de textes et d'images en contexte de vente au détail inclus. Cas d'utilisation: Création de chatbots retail multimodaux ou d'interfaces de recommandation e-commerce.
Tableau de comparaison
Ensemble de données
Échelle / Taille
Modalités
Solidité
Limitation
Muse
~7 83 conversations ; XNUMX XNUMX énoncés
Texte + Image
Spécificité des recommandations de mode
Domaine spécifique (mode)
MMDialog
1.08 M de conversions ; 1.53 M d'images
Texte + Image
Couverture thématique vaste et massive
Manipulation complexe
DeepDialogue
40 20 conversions, XNUMX émotions
Texte + Image
Progression des émotions et empathie
Plus récent, moins testé
MÉLANGER
13 XNUMX énoncés
Texte + Vidéo/Audio
Étiquetage des émotions multipartites
Plus petit, domaine limité
MIntRec2.0
15 XNUMX échantillons
Texte + Multimodal
Détection d'intention avec hors de portée
Objectif d'intention étroit
MMD
150 XNUMX sessions d'achat
Texte + Image
Dialogues spécifiques au commerce de détail
Domaine de vente au détail uniquement
Pourquoi ces ensembles de données sont importants
Ces riches ensembles de données aident les systèmes d’IA à :
Comprendre contexte au-delà des mots—comme des indices visuels ou des émotions.
Adaptez les recommandations avec réalisme (par exemple, Muse).
Construire des systèmes empathiques ou émotionnellement conscients (DeepDialogue, MÉLANGER).
Mieux détecter l'intention des utilisateurs et gérer les requêtes inattendues (MIntRec2.0).
Servir des interfaces conversationnelles dans les environnements de vente au détail (MMD).
L'essor des ensembles de données de conversations multimodales transforme l'IA, passant de simples robots textuels à des systèmes capables de voir, de ressentir et de comprendre en contexte.
De la logique de recommandation stylisée de Muse à l'étendue de MMDialog et à la sophistication des intentions de MIntRec2.0 , ces ressources alimentent une IA plus intelligente et plus empathique.
Chez Shaip , nous aidons les organisations à s'orienter dans le paysage des ensembles de données, en créant des données multimodales de haute qualité et issues de sources éthiques pour construire la prochaine génération de systèmes intelligents.
Qu'est-ce qu'un ensemble de données de conversations multimodales ?
Un ensemble de données dans lequel les dialogues sont associés à une image, un son ou une vidéo pour fournir un contexte plus riche.
Quel ensemble de données prend en charge la compréhension émotionnelle ?
DeepDialogue se concentre sur la progression des émotions ; MELD inclut une interaction multipartite étiquetée par émotion.
Quelle est la meilleure solution pour l’IA à domaine ouvert ?
MMDialog , avec plus d'un million de conversations et des sujets variés, est idéal pour les assistants polyvalents.
Quel ensemble de données aide à la détection des intentions ?
MIntRec2.0 inclut la détection hors périmètre et une taxonomie d'intention fine pour les systèmes d'entreprise robustes.
Ces ensembles de données sont-ils spécifiques à un domaine ?
Oui. Beaucoup sont spécialisées — mode ( Muse ), émotions ( DeepDialogue , MELD ), vente au détail ( MMD ), etc. — ce qui peut limiter la généralisation entre applications.
Cet article vous a plu ? Suivez Shaip sur LinkedIn pour plus d’actualités.
Nous utilisons des cookies pour améliorer votre expérience sur notre site. En utilisant notre site, vous acceptez l'utilisation des cookies.
Préférences de matières de cookies
Gérez vos préférences en matière de cookies ci-dessous :
Les cookies essentiels permettent des fonctions de base et sont nécessaires au bon fonctionnement du site Web.
Nom
Description
Durée
Préférences de matières de cookies
Ce cookie est utilisé pour stocker les préférences de consentement des cookies de l'utilisateur.
180 jours
Préférences de matières de cookies
Ce cookie est utilisé pour stocker les préférences de consentement des cookies de l'utilisateur.
180 jours
Configuration de géolocalisation
Ce cookie est utilisé pour stocker les paramètres de consentement en fonction de l'emplacement du visiteur.
180 jours
Préférences de matières de cookies
Ce cookie est utilisé pour stocker les préférences de consentement des cookies de l'utilisateur.
180 jours
Google Tag Manager simplifie la gestion des balises marketing sur votre site Web sans modification de code.
Nom
Description
Durée
ID_UTILISATEUR_TRINITY
-
TRINITY_DONNÉES_UTILISATEUR
-
td
Enregistre des données statistiques sur le comportement des utilisateurs sur le site Web. Utilisé pour l'analyse interne par l'opérateur du site Web.
Session
préférences de cookies
Enregistre les préférences de cookies d'un utilisateur
2 ans
Les cookies statistiques collectent des informations de manière anonyme. Ces informations nous aident à comprendre comment les visiteurs utilisent notre site web.
Google Analytics est un outil puissant qui suit et analyse le trafic du site Web pour des décisions marketing éclairées.
Contient des informations relatives aux campagnes marketing de l'utilisateur. Celles-ci sont partagées avec Google AdWords / Google Ads lorsque les comptes Google Ads et Google Analytics sont liés.
90 jours
__utma
ID utilisé pour identifier les utilisateurs et les sessions
2 ans après la dernière activité
__utmt
Utilisé pour surveiller le nombre de requêtes du serveur Google Analytics
10 minutes
__utmb
Utilisé pour distinguer les nouvelles sessions et visites. Ce cookie est défini lorsque la bibliothèque javascript GA.js est chargée et qu'il n'existe aucun cookie __utmb. Le cookie est mis à jour chaque fois que des données sont envoyées au serveur Google Analytics.
30 minutes après la dernière activité
__utmc
Utilisé uniquement avec les anciennes versions Urchin de Google Analytics et non avec GA.js. Il était utilisé pour faire la distinction entre les nouvelles sessions et les visites à la fin d'une session.
Fin de session (navigateur)
__utmz
Contient des informations sur la source de trafic ou la campagne qui a dirigé l'utilisateur vers le site Web. Le cookie est défini lorsque le javascript GA.js est chargé et mis à jour lorsque les données sont envoyées au serveur Google Analytics
6 mois après la dernière activité
__utmv
Contient des informations personnalisées définies par le développeur Web via la méthode _setCustomVar dans Google Analytics. Ce cookie est mis à jour chaque fois que de nouvelles données sont envoyées au serveur Google Analytics.
2 ans après la dernière activité
__utmx
Utilisé pour déterminer si un utilisateur est inclus dans un test A/B ou multivarié.
18 mois
_ga
ID utilisé pour identifier les utilisateurs
2 ans
_gali
Utilisé par Google Analytics pour déterminer quels liens sur une page sont cliqués
30 secondes
_Géorgie_
ID utilisé pour identifier les utilisateurs
2 ans
_gid
ID utilisé pour identifier les utilisateurs pendant 24 heures après la dernière activité
de 24 heures
_flingue
Utilisé pour surveiller le nombre de demandes de serveur Google Analytics lors de l'utilisation de Google Tag Manager
1 minute
Les cookies marketing sont utilisés pour suivre les visiteurs sur les sites web. L'objectif est de diffuser des publicités pertinentes et attrayantes pour chaque utilisateur.
Google Ads est une plateforme de publicité en ligne qui permet aux entreprises de créer des annonces ciblées affichées dans les résultats de recherche Google et sur les sites partenaires.
Cookie de ciblage. Utilisé pour créer un profil d'utilisateur et afficher des annonces Google pertinentes et personnalisées à l'utilisateur.
2 ans
__Secure-1PSID
Cookie de ciblage. Utilisé pour créer un profil d'utilisateur et afficher des annonces Google pertinentes et personnalisées à l'utilisateur.
2 ans
__Secure-3PAPISID
Établit le profil des intérêts des visiteurs du site Web pour diffuser des publicités pertinentes et personnalisées grâce au reciblage.
2 ans
AEC
Les cookies AEC garantissent que les requêtes effectuées au cours d'une session de navigation sont effectuées par l'utilisateur et non par d'autres sites. Ces cookies empêchent les sites malveillants d'agir au nom d'un utilisateur à l'insu de ce dernier.
6 mois
ID_VISITEUR_ADS
Cookie requis pour utiliser les options et services web du site
2 mois
__Secure-3PSIDCC
Cookie de ciblage. Utilisé pour créer un profil d'utilisateur et afficher des annonces Google pertinentes et personnalisées à l'utilisateur.
2 ans
__Secure-3PSIDTS
Cookie de ciblage. Utilisé pour créer un profil d'utilisateur et afficher des annonces Google pertinentes et personnalisées à l'utilisateur.
2 ans
__Secure-1PSIDTS
Cookie de ciblage. Utilisé pour créer un profil d'utilisateur et afficher des annonces Google pertinentes et personnalisées à l'utilisateur.
2 ans
__Secure-1PAPISID
Cookie de ciblage. Utilisé pour créer un profil d'utilisateur et afficher des annonces Google pertinentes et personnalisées à l'utilisateur.
2 ans
__Secure-3PSID
Cookie de ciblage. Utilisé pour profiler les intérêts des visiteurs du site Web et afficher des annonces Google pertinentes et personnalisées.
2 ans
Conversion
Google utilise des cookies à des fins publicitaires, notamment pour diffuser et restituer des annonces, personnaliser les annonces (en fonction de vos paramètres d'annonce sur g.co/adsettings), limiter le nombre de fois qu'une annonce est affichée à un utilisateur, désactiver les annonces que vous avez choisi de ne plus voir et mesurer l'efficacité des annonces.
90 jours
_gcl_aw
Google utilise des cookies à des fins publicitaires, notamment pour diffuser et restituer des annonces, personnaliser les annonces (en fonction de vos paramètres d'annonce sur g.co/adsettings), limiter le nombre de fois qu'une annonce est affichée à un utilisateur, désactiver les annonces que vous avez choisi de ne plus voir et mesurer l'efficacité des annonces.
90 jours
_gcl_gs
Google utilise des cookies à des fins publicitaires, notamment pour diffuser et restituer des annonces, personnaliser les annonces (en fonction de vos paramètres d'annonce sur g.co/adsettings), limiter le nombre de fois qu'une annonce est affichée à un utilisateur, désactiver les annonces que vous avez choisi de ne plus voir et mesurer l'efficacité des annonces.
90 jours
_gcl_fr
Google utilise des cookies à des fins publicitaires, notamment pour diffuser et restituer des annonces, personnaliser les annonces (en fonction de vos paramètres d'annonce sur g.co/adsettings), limiter le nombre de fois qu'une annonce est affichée à un utilisateur, désactiver les annonces que vous avez choisi de ne plus voir et mesurer l'efficacité des annonces.
90 jours
_gac_gb_
Google utilise des cookies à des fins publicitaires, notamment pour diffuser et restituer des annonces, personnaliser les annonces (en fonction de vos paramètres d'annonce sur g.co/adsettings), limiter le nombre de fois qu'une annonce est affichée à un utilisateur, désactiver les annonces que vous avez choisi de ne plus voir et mesurer l'efficacité des annonces.
90 jours
FPGCLGB
Google utilise des cookies à des fins publicitaires, notamment pour diffuser et restituer des annonces, personnaliser les annonces (en fonction de vos paramètres d'annonce sur g.co/adsettings), limiter le nombre de fois qu'une annonce est affichée à un utilisateur, désactiver les annonces que vous avez choisi de ne plus voir et mesurer l'efficacité des annonces.
90 jours
Griffe FPG
Google utilise des cookies à des fins publicitaires, notamment pour diffuser et restituer des annonces, personnaliser les annonces (en fonction de vos paramètres d'annonce sur g.co/adsettings), limiter le nombre de fois qu'une annonce est affichée à un utilisateur, désactiver les annonces que vous avez choisi de ne plus voir et mesurer l'efficacité des annonces.
90 jours
HubSpot est une plateforme tout-en-un de marketing, de vente et de service client qui simplifie la croissance des entreprises.
Ce cookie est utilisé pour reconnaître les visiteurs qui discutent avec vous via l'outil de chat. Si le visiteur quitte votre site avant d'être ajouté comme contact, ce cookie sera associé à son navigateur.
13 mois
__hs_do_not_track
Ce cookie peut être défini pour empêcher le code de suivi d'envoyer des informations à HubSpot.
13 mois
__hs_cookie_cat_pref
Ce cookie sert à enregistrer les catégories auxquelles un visiteur a consenti.
6 mois
__hs_initial_opt_in
Ce cookie est utilisé pour empêcher la bannière de s'afficher toujours lorsque les visiteurs naviguent en mode strict.
7 jours
__hs_gpc_banner_dismiss
Ce cookie est utilisé lorsque la bannière de contrôle global de la confidentialité est fermée.
180 jours
hs_ab_test
Ce cookie est utilisé pour proposer systématiquement aux visiteurs la même version d'une page de test A/B qu'ils ont vue auparavant.
Session
__hs_notify_banner_dismiss
Ce cookie est utilisé lorsque le site web utilise une bannière de consentement de type « Notify ».
180 jours
hs-messages-is-open
Ce cookie est utilisé pour déterminer et enregistrer si le widget de chat est ouvert pour de futures visites.
30 minutes
hs-messages-hide-welcome-message
Ce cookie est utilisé pour empêcher le message de bienvenue du widget de chat de réapparaître pendant un jour après sa suppression.
1 jour
__hsmem
Ce cookie est défini lorsque les visiteurs se connectent à un site hébergé par HubSpot.
1 an
hs-membership-csrf
Ce cookie est utilisé pour garantir que les connexions d'adhésion au contenu ne peuvent pas être falsifiées.
Session
hs_langswitcher_choice
Ce cookie est utilisé pour enregistrer le choix de langue sélectionné par le visiteur lors de la consultation de pages en plusieurs langues.
2 ans
__hstc
Le cookie principal pour le suivi des visiteurs.
13 mois
hubspotutk
Ce cookie enregistre l'identité du visiteur. Il est transmis à HubSpot lors de la soumission du formulaire et utilisé lors de la déduplication des contacts.
13 mois
__hssc
Ce cookie garde une trace des sessions.
30 minutes
__hssrc
Chaque fois que HubSpot modifie le cookie de session, ce cookie est également défini pour déterminer si le visiteur a redémarré son navigateur.
Session
Préférences de l'API HubSpot
Ceci est utilisé avec le cookie hubspotapi pour se souvenir si l'utilisateur a coché la case « se souvenir de moi » (contrôle l'expiration de l'authentification du cookie principal).
1 Ans
hubspotapi-csrf
Ce dispositif sert à prévenir les attaques CSRF, empêchant ainsi les sites web tiers d'accéder à vos données. Il expire au bout d'un an.
1 an
__hs_opt_out
Ce cookie est utilisé par la politique de confidentialité opt-in pour se rappeler de ne pas demander à nouveau au visiteur d'accepter les cookies.
13 mois
API Hubspot
Ce cookie permet à l'utilisateur d'accéder à l'application avec les autorisations appropriées.