Si l'on s'en tient aux scores automatisés, la plupart des LLM semblent excellents, jusqu'à ce qu'ils contiennent une erreur subtile, une formulation risquée ou un ton inapproprié. C'est là le fossé entre ce que mesurent les benchmarks statiques et les besoins réels de vos utilisateurs. Ce guide explique comment combiner l'expertise humaine (HITL) et l'automatisation afin que l'évaluation de vos LLM reflète la fiabilité, la sécurité et l'adéquation au domaine, et non une simple précision au niveau des jetons.
Ce que mesure réellement l'analyse comparative des LLM
Les indicateurs et classements automatisés sont rapides et reproductibles. La précision des tâches à choix multiples, le score BLEU/ROUGE pour la similarité textuelle et la perplexité pour la modélisation du langage fournissent des indications. Cependant, ils passent souvent à côté des raisonnements, des fondements factuels et du respect des politiques, notamment dans les contextes à forts enjeux. C'est pourquoi les programmes modernes privilégient une approche multi-indicateurs, des rapports transparents et un réalisme accru des scénarios.
Métriques automatisées et ensembles de tests statiques
Considérez les indicateurs classiques comme un compteur de vitesse : ils indiquent parfaitement votre vitesse sur une autoroute en bon état. Mais ils ne vous disent pas si les freins fonctionnent sous la pluie. Les codes BLEU/ROUGE/perplexité facilitent la comparaison, mais ils peuvent être manipulés par la mémorisation ou une simple ressemblance.
Là où ils échouent
Les utilisateurs réels sont sources d'ambiguïté, de jargon technique, d'objectifs contradictoires et de réglementations évolutives. Les jeux de tests statiques peinent souvent à refléter ces réalités. Par conséquent, les benchmarks purement automatisés surestiment la capacité des modèles à gérer des tâches complexes en entreprise. Des initiatives communautaires comme HELM/AIR-Bench remédient à ce problème en couvrant davantage de dimensions (robustesse, sécurité, transparence) et en publiant des suites de tests transparentes et évolutives.
Plaidoyer pour l’évaluation humaine dans les référentiels de maîtrise en droit
Certaines qualités demeurent obstinément humaines : le ton, la serviabilité, la justesse subtile, l’adéquation culturelle et la prise de risque. Les évaluateurs humains – correctement formés et calibrés – sont les meilleurs outils dont nous disposons pour les évaluer. L’enjeu est de les utiliser de manière sélective et systématique , afin de maîtriser les coûts tout en maintenant un niveau de qualité élevé.
Quand impliquer les humains
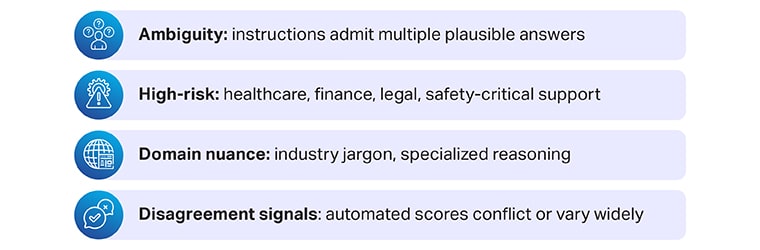
- Ambiguïté: Les instructions admettent plusieurs réponses plausibles.
- À haut risque : soins de santé, finances, services juridiques, soutien aux secteurs critiques pour la sécurité.
- nuance de domaine : Jargon industriel, raisonnement spécialisé.
- Signaux de désaccord : Les scores automatisés sont contradictoires ou très variables.
Conception de grilles d'évaluation et étalonnage (exemple simple)
Utilisez une échelle de 1 à 5 pour évaluer l'exactitude , la pertinence et la conformité aux politiques . Fournissez 2 à 3 exemples commentés pour chaque note. Organisez de courtes phases de calibration : les évaluateurs notent un lot commun, puis comparent leurs justifications afin d'améliorer la cohérence. Suivez l'accord inter-évaluateurs et exigez une décision pour les cas limites.
Méthodes : De LLM-en-tant-que-juge à véritable HITL
L'utilisation d'un modèle pour évaluer un autre modèle (LLM-as-a-Judge) est utile pour le triage : c'est rapide, peu coûteux et efficace pour les vérifications simples. Cependant, cette méthode peut présenter les mêmes angles morts : hallucinations, corrélations fallacieuses ou surévaluation des notes. Il convient de l'utiliser pour prioriser les cas nécessitant une évaluation humaine, et non pour remplacer cette dernière.
Un pipeline hybride pratique
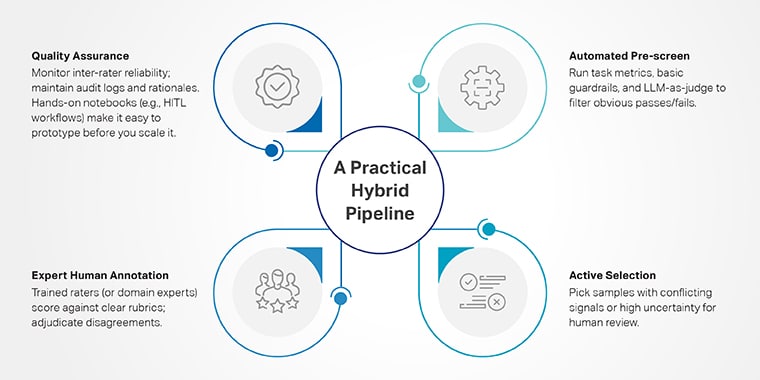
- Présélection automatisée : Exécuter des mesures de performance des tâches, des garde-fous de base et utiliser LLM comme juge pour filtrer les réussites/échecs évidents.
- Sélection active : Sélectionner les échantillons présentant des signaux contradictoires ou une incertitude élevée pour un examen humain.
- Annotation humaine experte : Des évaluateurs formés (ou des experts du domaine) attribuent des notes selon des grilles d'évaluation claires ; ils tranchent les désaccords.
- Assurance qualité: Surveiller la fiabilité inter-évaluateurs ; tenir à jour les journaux d’audit et les justifications. Des carnets de notes pratiques (par exemple, les flux de travail HITL) facilitent le prototypage de cette boucle avant son déploiement à grande échelle.
Tableau comparatif : Automatisation vs LLM-as-Judge vs HITL
Les indicateurs de sécurité et de risque sont différents
Les organismes de réglementation et de normalisation exigent des évaluations qui documentent les risques, testent des scénarios réalistes et démontrent la supervision. Le cadre de gestion des risques liés à l'IA du NIST (profil GenAI 2024) fournit un vocabulaire et des pratiques communs ; le programme d'évaluation GenAI du NIST met en place des tests spécifiques à chaque domaine ; et HELM/AIR-Bench met en avant des résultats transparents et multimétriques. Utilisez ces ressources pour étayer votre argumentaire en matière de gouvernance.
Éléments à collecter pour les audits de sécurité
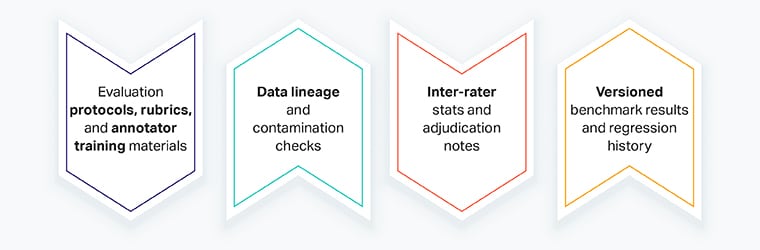
- Évaluation protocoles, rubriques et formation des annotateurs matériaux
- Lignée de données et contrôles de contamination
- Inter-évaluateurs notes statistiques et d'arbitrage
- Versionné Résultats de référence et historique de régression
Mini-article : Réduire les faux positifs dans la procédure KYC bancaire
L'équipe d'analystes KYC d'une banque a testé deux modèles de synthèse des alertes de conformité. Les scores automatisés étaient identiques. Lors d'une analyse HITL, les évaluateurs ont constaté que le modèle A omettait fréquemment des qualificateurs négatifs (« aucune sanction antérieure »), en inversant le sens. Après examen, la banque a opté pour le modèle B et mis à jour ses alertes. Les faux positifs ont diminué de 18 % en une semaine, permettant aux analystes de se consacrer à des investigations plus approfondies. (Leçon à retenir : les scores automatisés ont manqué une erreur subtile mais lourde de conséquences ; HITL l'a détectée.)
Où Shaip aide
- Glossaire et éducation : Explication en langage clair de l'importance de l'intervention humaine dans la boucle et de son rôle dans l'IA de génération.
- Procédure et stratégie : A Guide du débutant pour l'évaluation du LLM pour les équipes qui partent de zéro.
- Plate-forme: A Plateforme d'évaluation et de surveillance de l'IA générative pour opérationnaliser le triage, les expériences et les audits.