En exploitant le PNL basé sur l'IA pour extraire des données structurées à partir de vastes dossiers médicaux électroniques non structurés, les chercheurs ont accès à des ensembles de données cliniques à grande échelle pour des études épidémiologiques, la santé de la population et la découverte d'informations médicales qui resteraient autrement cachées.
Extraction de détails à partir de données de DSE non structurées : exemple de flux de travail
L'extraction d'informations à partir de données DMP non structurées est un processus systématique qui doit être réalisé au cas par cas. Les exigences du domaine, les préoccupations et défis propres à l'organisation de soins, les applications ciblées et leurs implications sont subjectifs. C'est pourquoi le processus doit également prendre en compte les facteurs qui influencent votre organisation et sa vision.
Cependant, comme chaque approche a un flux de travail spécifique ou une approche empirique, nous avons également répertorié un guide auquel vous pouvez également vous référer.
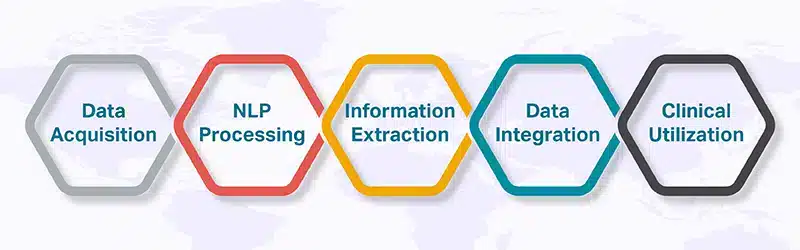
Acquisition et prétraitement des données : La première étape consiste à compiler les données du dossier médical électronique (DME) contenant les notes cliniques, les listes de médicaments, les listes d’allergies et les comptes rendus d’interventions. Le prétraitement par IA comprend l’anonymisation, le nettoyage, la normalisation et la tokenisation afin de préparer les données dans des formats cohérents (formats texte, structurés ou non structurés).
Traitement NLP / Entraînement de modèles d'IA : Les données compilées sont ensuite intégrées à vos algorithmes NLP ou modèles d'IA afin d'analyser les données textuelles et d'identifier les entités cliniques clés telles que les diagnostics, les médicaments, les allergies et les interventions. L'entraînement en « mode IA » repose sur un apprentissage supervisé, parfois non supervisé ou semi-supervisé, à l'aide d'ensembles de données étiquetés.
Extraction d'informations : selon que votre modèle suit des stratégies d'apprentissage supervisé ou non supervisé (ou un mode d'IA hybride), il extrait les informations pertinentes sur chaque entité, notamment son type, sa date, les détails associés, sa gravité, son dosage, etc.
Validation et supervision clinique : Une fois que le modèle d’IA a extrait les informations, celles-ci doivent être validées par des professionnels de santé afin de garantir leur exactitude clinique. L’intervention humaine et les boucles de rétroaction d’experts assurent la fiabilité de l’extraction.
Intégration et interopérabilité des données : Les données structurées sont ensuite intégrées au système de dossier médical électronique (DME) ou à d’autres bases de données pertinentes. Ceci garantit la conformité aux normes HL7 FHIR et autres normes de santé, et favorise l’interopérabilité.
Cycle d'utilisation clinique et de rétroaction : L'intégration permet aux professionnels de santé d'utiliser les informations extraites pour la prise de décision clinique, la recherche et les initiatives de santé publique. Les boucles de rétroaction du mode IA contribuent à améliorer la précision du modèle au fil du temps, en s'adaptant à de nouveaux types de données ou à de nouveaux schémas linguistiques.
Défis liés à l'exploitation du traitement du langage naturel (NLP) pour extraire les données du DSE
L'extraction de données non structurées à partir des DMP est une tâche ambitieuse qui peut simplifier la vie des acteurs de la santé. Cependant, des obstacles peuvent entraver la mise en œuvre fluide. Examinons les problèmes les plus courants afin d'élaborer des stratégies proactives pour les résoudre ou les atténuer.
Qualité, variété et biais des données : La précision de l’extraction par TALN dépend de la qualité, de la cohérence et de la représentativité des données des dossiers médicaux électroniques. Des formats et terminologies différents, des enregistrements incomplets ou des échantillons biaisés peuvent dégrader les performances du modèle d’IA.
Confidentialité, sécurité et conformité en mode IA : des mesures doivent être mises en œuvre pour garantir la confidentialité des données des patients et la sécurité de leurs données lors du traitement et du stockage par IA/NLP. Les réglementations telles que le RGPD et la loi HIPAA doivent être respectées. Cela inclut l’anonymisation, le stockage sécurisé et le contrôle d’accès.
Validation clinique et interprétabilité : Les informations extraites doivent être validées par des professionnels de santé afin de garantir leur exactitude et leur pertinence clinique. Une terminologie complexe, un phrasé ambigu ou des pathologies rares peuvent induire les modèles en erreur. De plus, les systèmes d’IA doivent être explicables pour que les cliniciens leur fassent confiance.
Intégration, interopérabilité et normes : les données extraites doivent s’intégrer parfaitement aux systèmes de dossiers médicaux électroniques existants et aux autres systèmes informatiques de santé. Les modèles d’IA doivent prendre en charge les normes HL7, FHIR, SNOMED, RadLex, etc., afin de garantir l’interopérabilité.
Évolutivité et maintenance : En mode IA, les systèmes nécessitent un réentraînement, une surveillance et une mise à jour continue pour tenir compte des nouvelles pratiques cliniques, de l’évolution de la terminologie médicale ou des changements de style de documentation.
Coûts et ressources nécessaires : Le développement, la formation, la validation et le déploiement de systèmes de traitement automatique du langage naturel (TALN) basés sur l’IA nécessitent des investissements dans l’annotation des données, la supervision d’experts, les ressources informatiques et le personnel qualifié.
Réflexions finales
En résumé, le potentiel est illimité lorsqu'on déploie le traitement automatique du langage naturel (TALN) basé sur l'IA pour extraire des données de santé des dossiers médicaux électroniques. Pour une mise en œuvre sans faille, nous recommandons de prendre en compte les difficultés, de renforcer la supervision clinique et de garantir un déploiement responsable en mode « IA ».
Si vous souhaitez garantir une conformité totale aux exigences en matière de données de santé et obtenir les meilleures données d'entraînement pour vos modèles d'IA, contactez-nous. Pionniers du secteur, nous maîtrisons parfaitement le domaine, vos objectifs d'entreprise et les subtilités de l'entraînement d'un modèle de traitement automatique du langage naturel (TALN) clinique, optimisé pour le secteur de la santé et doté d'une IA performante. Contactez-nous dès aujourd'hui.