Les données longitudinales des patients regroupent les informations de santé les concernant, recueillies de manière répétée au fil du temps et dans différents contextes de soins : consultations, diagnostics, résultats d’analyses, traitements médicamenteux, imagerie, interventions et résultats, le tout organisé dans une chronologie. Illustrant l’ évolution de la santé d’un patient plutôt qu’une simple image, elles constituent le fondement de la gestion des maladies chroniques, des études en vie réelle et des modèles d’intelligence artificielle modernes permettant de prédire l’évolution de la santé.
Points clés à retenir
- Les données longitudinales des patients regroupent de nombreuses consultations pour une même personne dans un dossier chronologique ; une visite ou une enquête unique est transversale.
- Les sources courantes sont les dossiers médicaux électroniques et les notes cliniques, les demandes de remboursement, les données de laboratoire et de pharmacie, l'imagerie, les registres et les données générées par les patients — souvent liées entre elles.
- Sa construction dépend de l'appariement des patients, de normes telles que HL7 FHIR et le modèle de données commun OMOP, et d'une dé-identification conforme à la loi HIPAA.
- Pour l'IA, les données longitudinales alimentent les modèles de progression et de risque des maladies ainsi que les modèles de base des dossiers médicaux électroniques ; des ensembles de données de référence tels que EHRSHOT existent parce que les données d'une seule visite ne permettent pas de tester ces tâches.
- Les principaux risques sont les données manquantes, la fragmentation, les erreurs de liaison et les biais — autant d'éléments qu'un fournisseur de données devrait être en mesure de documenter.
Que sont les données longitudinales des patients ?
Définition et chronologie simplifiée du parcours patient
La même idée se retrouve dans la définition d'un dossier médical électronique : un DME est un enregistrement numérique des informations de santé d'un patient, constitué au fil du temps, à partir d'une ou plusieurs visites et dans différents contextes de soins.
Voici à quoi ressemble une chronologie simplifiée et illustrative du parcours d'un patient :
Types de données longitudinales sur les patients
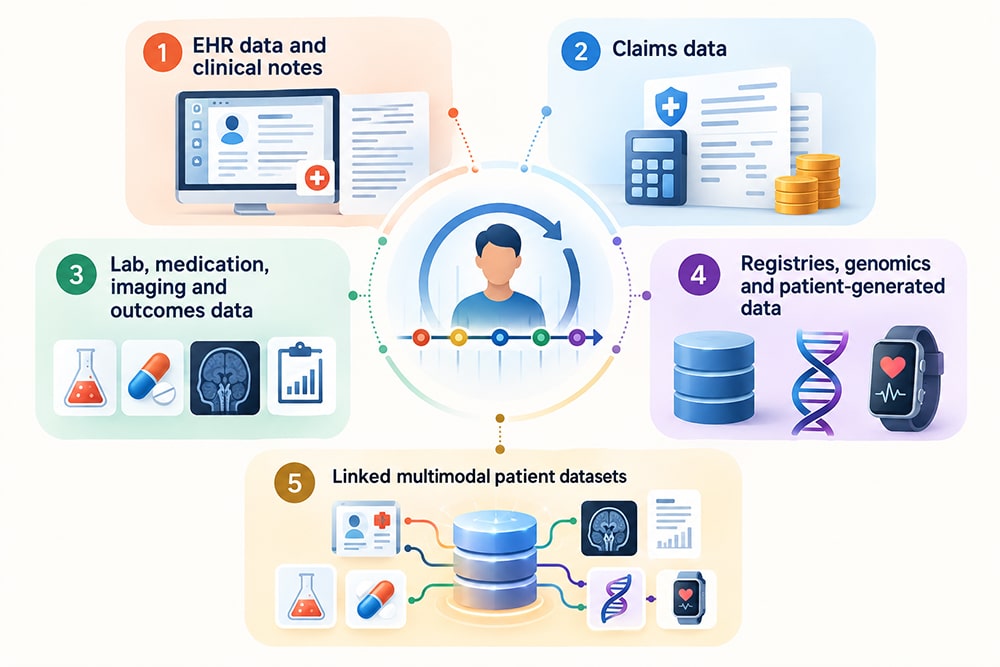
Données du dossier médical électronique et notes cliniques
Les dossiers médicaux électroniques (DME) contiennent des champs structurés (diagnostics, liste des problèmes, constantes vitales, prescriptions, médicaments, résultats de laboratoire) et du texte non structuré (notes d'évolution, résumés de sortie, rapports de radiologie et d'anatomopathologie). Leur adoption est quasi universelle dans les hôpitaux américains : l'ONC indique qu'en 2024, plus de 99 % des hôpitaux de soins aigus non fédéraux avaient adopté un DME certifié ( HealthIT.gov ). Une grande partie des informations cliniques importantes se trouve sous forme de texte libre, d'où la nécessité du traitement automatique du langage naturel (TALN) et de l'annotation pour rendre les notes exploitables.
Données sur les sinistres
Les dossiers médicaux et pharmaceutiques recensent les services facturés, les codes de diagnostic et d'intervention, les médicaments délivrés et leurs coûts. Ces dossiers servent à justifier le paiement, tandis que les données du dossier médical électronique (DME) sont générées pour les soins cliniques. Les dossiers suivent le patient d'un professionnel de santé à l'autre au sein d'un même organisme payeur, mais contiennent peu de détails cliniques.
Données de laboratoire, de médicaments, d'imagerie et de résultats
- Données de laboratoire : Les résultats répétés (HbA1c, eGFR, lipides, marqueurs tumoraux) montrent l'évolution d'une maladie.
- Données sur les médicaments : Les ordonnances, les délivrances en pharmacie et les interruptions de traitement témoignent de l'observance, des changements de traitement et de la réponse au traitement.
- Imaging: Des examens en série accompagnés de rapports permettent de suivre l'évolution ou la réponse (par exemple, la taille de la tumeur au fil du temps).
- Résultats: Les hospitalisations, les réadmissions, les complications et la mortalité permettent de boucler la boucle sur ce qui s'est passé.
Registres, génomique et données générées par les patients
Les registres de maladies suivent des cohortes définies au fil du temps. Les données génomiques et pathologiques apportent un contexte moléculaire, tandis que les dispositifs portables ou les résultats rapportés par les patients ajoutent des données entre les visites.
Ensembles de données multimodales liés aux patients
Les ensembles de données les plus pertinents relient plusieurs de ces sources pour un même patient (anonymisé). Les compromis se présentent ainsi :
Comment fonctionnent les données longitudinales des patients
Mise en relation des dossiers entre les différentes consultations (appariement et liaison des patients)
Les dossiers médicaux des patients sont dispersés entre hôpitaux, cliniques, laboratoires, pharmacies et organismes payeurs, chacun possédant ses propres identifiants. Les relier est plus complexe qu'il n'y paraît : Pew cite une étude commandée par l'ONC qui a révélé des taux de concordance aussi faibles que 50 %, même entre des organisations utilisant le même fournisseur de dossier médical électronique ( Pew Charitable Trusts, 2018 ).
Méthodes de liaison courantes :
- Correspondance déterministe — Associe les enregistrements à l'aide d'identifiants exacts. Précis, mais ne détecte pas les fautes de frappe, les changements de nom et les nouvelles adresses.
- Appariement probabiliste — évalue la similarité entre des champs tels que le nom, la date de naissance et l'adresse afin de détecter les variantes.
- Liaison d'enregistrements préservant la confidentialité (tokenisation) — convertit les identifiants en jetons chiffrés afin que des ensembles de données anonymisées provenant de différentes sources puissent être liés sans exposer d'informations personnelles.
Normalisation des données
Les données liées ne sont utiles que si elles parlent un langage commun :
- HL7 FHIR — La norme HL7 pour l'échange de données de santé entre systèmes.
- USCDI — les données de base américaines pour l'interopérabilité, l'ensemble normalisé de classes et d'éléments de données de santé de l'ONC pour un échange à l'échelle nationale.
- Modèle de données commun OMOP — une norme OHDSI ouverte qui harmonise la structure et le contenu des données d'observation afin que la même analyse puisse être appliquée à de nombreuses bases de données.
- systèmes de codage clinique tels que la CIM-10 (diagnostics), le CPT/HCPCS (procédures), le LOINC (laboratoires), le RxNorm/NDC (médicaments) et le SNOMED CT (termes cliniques).
L'interopérabilité s'améliore mais reste incomplète, de sorte que de nombreux hôpitaux ne peuvent pas encore envoyer, recevoir, trouver et intégrer systématiquement les dossiers externes.
Anonymisation des données
Aux États-Unis, la règle de confidentialité de la loi HIPAA prévoit deux méthodes d'anonymisation pour les données secondaires : l'expertise par un spécialiste qualifié et la suppression, selon la méthode Safe Harbor, de 18 identifiants spécifiques, dont tous les éléments des dates à l'exception de l'année ( HHS ). Les dates sont importantes pour les données longitudinales, car les intervalles entre les événements ont une signification clinique ; la méthode d'anonymisation doit donc être choisie en tenant compte de la chronologie du patient.
Organiser des événements en fonction du calendrier du patient
Une fois appariées, standardisées et anonymisées, chaque donnée est datée (avec un décalage temporel) et ordonnée par patient : consultation → diagnostic → prescription → résultat → traitement → évolution. Cette chronologie constitue l’unité de mesure utilisée par les analystes et les modèles d’IA.
Exemples de parcours de soins longitudinaux des patients
Les exemples ci-dessous illustrent le parcours de patients, et non celui de patients réels.
Parcours du patient diabétique
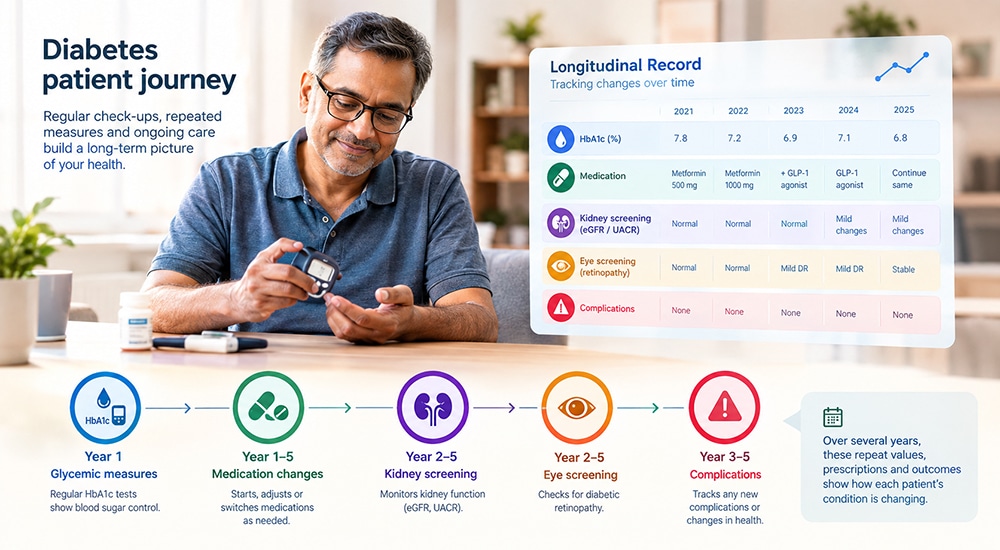
Une personne atteinte de diabète de type 2 constitue un dossier longitudinal classique : mesures répétées de la glycémie (HbA1c), initiation et modification de traitements, dépistage des maladies rénales et ophtalmologiques, et complications. Grâce à la réévaluation régulière du statut glycémique, ce dossier forme une série temporelle naturelle. Sur plusieurs années, ces valeurs répétées, les prescriptions et les résultats observés permettent de suivre l’évolution de l’état de santé de chaque patient.
Traitements et résultats en oncologie
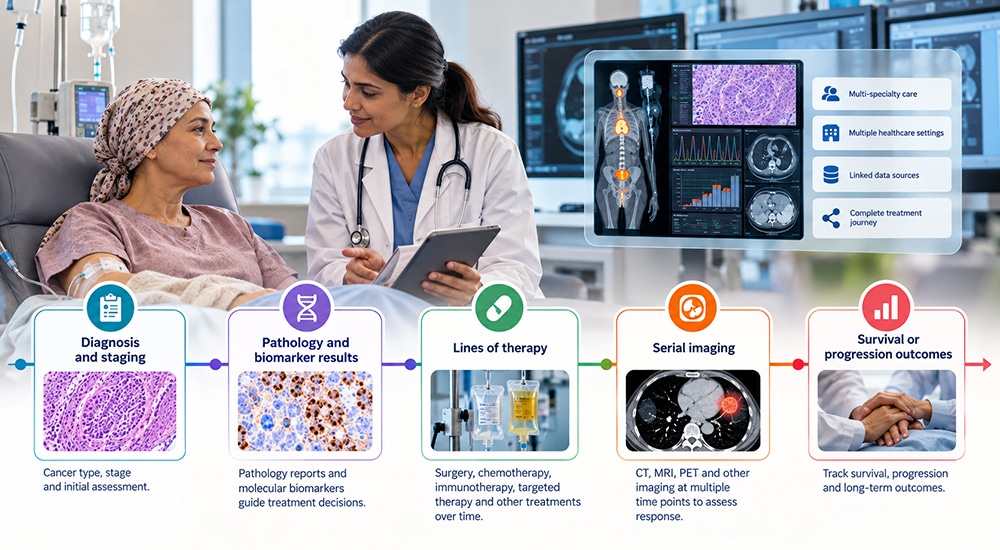
Le parcours de soins en cancérologie associe le diagnostic et le stade de la maladie, les résultats d'anatomopathologie et de biomarqueurs, les différentes lignes de traitement, l'imagerie sérielle et l'évolution de la maladie (survie ou progression). La prise en charge du cancer implique généralement plusieurs spécialités et contextes ; le schéma thérapeutique complet n'est donc visible que lorsque ces différentes sources sont reliées entre elles.
Réponse au médicament au fil du temps
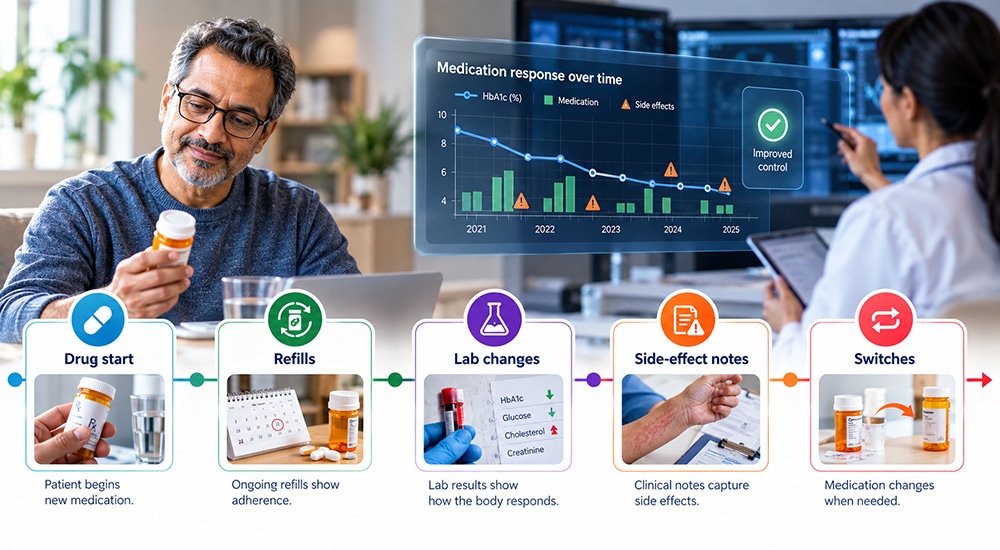
Le suivi d'un traitement médicamenteux, incluant les renouvellements d'ordonnance, les modifications des résultats d'analyses, les observations d'effets indésirables et les changements de traitement, permet d'évaluer son efficacité et l'observance en situation réelle. La FDA désigne ce type d'informations recueillies de façon systématique sous le terme de données en vie réelle (DVR), et les données cliniques issues de leur analyse sous celui de preuves en vie réelle (PVR).
Pourquoi les données longitudinales des patients sont importantes pour la recherche et les essais cliniques
- Preuves du monde réel : Le programme de données probantes en situation réelle de la FDA, créé dans le cadre de la loi 21st Century Cures Act, examine comment les données en situation réelle peuvent étayer les décisions réglementaires.
- Conception et faisabilité de l'essai : L'analyse des parcours de soins antérieurs des patients permet d'estimer le nombre de patients éligibles et la rapidité avec laquelle les résultats se produisent.
- Comparateurs externes et suivi à long terme : Les enregistrements longitudinaux permettent de prolonger l'observation au-delà de la date de fin d'un essai.
- Surveillance de la sécurité : Les séquences d'exposition → événement constituent la base de la pharmacovigilance.
- Qualité des soins : Les cliniciens peuvent suivre l'évolution des résultats de laboratoire et des constantes vitales au fil des consultations au lieu d'examiner chaque rencontre isolément.
Données longitudinales des patients pour l'entraînement de l'IA
Modèles prédictifs et progression de la maladie
Ce sont les données chronologiques des dossiers médicaux électroniques (DME) qui permettent aux modèles de faire des prédictions. Dans une étude largement citée, Google et ses partenaires universitaires ont entraîné des modèles d'apprentissage profond sur 46 864 534 945 points de données DME provenant de 216 221 hospitalisations (114 003 patients), prédisant la mortalité hospitalière, la réadmission non planifiée à 30 jours, la durée de séjour prolongée et les diagnostics de sortie ; la prédiction de la mortalité a atteint une aire sous la courbe ROC (AUROC) de 0.93 à 0.95 dans deux hôpitaux ( Rajkomar et al., npj Digital Medicine , 2018 ).
modèles de base du dossier médical électronique
Les modèles plus récents sont pré-entraînés sur des chronologies complètes de patients, tout comme les modèles de langage sont pré-entraînés sur du texte :
- Med-BERT adapte l'architecture BERT aux données EHR structurées, en effectuant un pré-entraînement sur de grands volumes de diagnostics codés à travers les visites des patients.
- La prospective est un transformateur génératif entraîné sur les chronologies des patients hospitalisés au Royaume-Uni et sur MIMIC-III pour prévoir les troubles futurs.
Masters en droit médical et PNL clinique
Les notes cliniques constituent la couche narrative du dossier longitudinal. Les logiciels de gestion de l'apprentissage automatique (LLM) médicaux et les pipelines de traitement automatique du langage naturel (TALN) extraient de ces notes les problèmes, les médicaments, les chronologies et les résultats ; ils ont besoin de notes annotées et dépersonnalisées sur de nombreuses visites pour comprendre l'évolution de l'histoire d'un patient.